Agent Swarmを使うと、これまで数日かかっていた広範な調査を短時間で並列化できます。ところが実際に使い始めると、別の問題がすぐに現れます。エージェントが300件の資料や回答を集めたとして、その300件を今度は誰が読み、矛盾を見つけ、同じ人物や企業を結び付け、次回の調査へ引き継ぐのでしょうか。
大量の成果物をフォルダへ保存しただけでは、検索できる資料置き場が増えただけです。本当に価値があるのは、個別の回答よりも「同じ対象を扱っている」「この主張はこの一次情報に基づく」「別々の調査が同じリスク要因へ到達した」といった接続です。
本記事では、Agent Swarmの出力を文書の山で終わらせず、Source(根拠)・Claim(主張)・Entity(対象)・Artifact(成果物)を結ぶ知識グラフへ変換する方法を説明します。Kimiの機能紹介は、先に公開した「Kimi Agent Swarmとは?最大300エージェントで調査・制作を並列化」を参照してください。
この記事の要点
- Agent Swarmは「集める・作る」を水平に拡張できる
- 知識グラフは「つなぐ・確かめる・再利用する」を担う
- 巨大なグラフDBは不要。JSONとNetworkXで価値検証できる
- ノードより、根拠・時刻・確信度を持つエッジ設計が重要
- 自動化してよいのは収集と候補生成まで。公開・重要判断は人間のゲートを残す
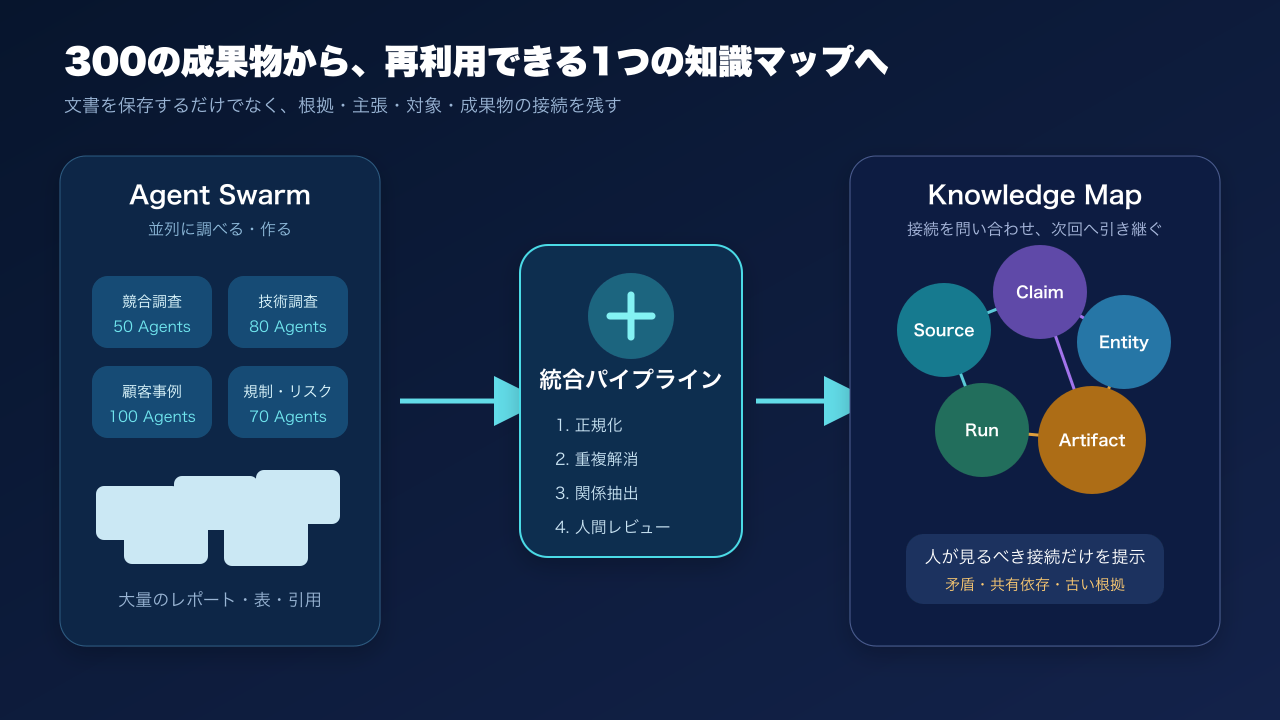
本文図1:並列エージェントの出力を正規化し、主張・対象・根拠・成果物を1つのグラフへ統合する。
なぜ「300の回答」では足りないのか
100個の要素には4,950通り、300個には44,850通りの組み合わせがあります。全件確認は不要でも、「どの結果同士を照合すべきか」を文書名だけから判断するのは現実的ではありません。
例えば競合、技術、顧客事例、規制を別々のエージェント群へ任せると、各レポートが読みやすくても次の横断関係は見落とされやすくなります。
- 複数の競合が同じ基盤モデルやクラウドへ依存している
- 別名で記載された2社が、実は同じ親会社の傘下にある
- 製品の強みとして挙げた機能が、規制面では共通リスクになる
- 3つの出典が同じ二次記事を参照しており、独立した裏付けではない
- ある結論が古い価格表に基づき、現在の公式情報と衝突している
文書中心の管理では、こうした関係は本文の中に埋まります。全文検索で社名を探すことはできても、「同じ一次情報に依存する主張」「同じ対象について矛盾する主張」「複数案件にまたがる単一障害点」を直接問い合わせるのは難しいままです。
そこで、成果を文書単位だけで保存せず、意味のある最小単位へ分解して接続します。知識グラフ化の目的は、すべてを複雑なデータベースへ移すことではありません。再確認すべき接続を機械が絞り、人間が判断できる大きさへ戻すことです。
Agent Swarmと知識グラフは別の層である
まず重要なのは、Agent Swarmと知識グラフを同じ機能として扱わないことです。
Moonshot AIの公式情報によると、Kimi Agent SwarmはKimi K2.5で導入され、K2.6では最大300のサブエージェントと4,000超のツール呼び出しに拡張されました。公式ヘルプは、単一エージェントより約4.5倍高速という測定値や、各サブエージェントが独立したノートブックへ詳細を保持し、要点をオーケストレーターへ返すContext Shardingも説明しています。これらは2026年8月16日時点の公式情報であり、提供条件や上限は今後変わり得ます(Moonshot AI公式ヘルプ、Kimi K2.5公式リポジトリ)。
これは主に「実行の拡張」です。タスクを分割し、同時に調べ、同時に作ることで、完了までのクリティカルパスを短くします。一方、知識グラフは「記憶と関係の拡張」です。誰が何を調べ、どの情報を使い、どの主張を作り、別の成果とどうつながったかを、次回も問い合わせられる形で残します。
役割を分けると、設計が明確になります。
| 層 | 主な役割 | 代表的な問い |
|---|---|---|
| Agent Swarm | 分解、並列実行、成果生成 | 何を同時に調べるか |
| 統合パイプライン | 正規化、重複解消、関係抽出 | 同じ対象・主張はどれか |
| 知識グラフ | 関係と来歴の保持 | 何と何が、なぜつながるか |
| レビューUI | 例外、矛盾、重要接続の提示 | 人間は何を判断すべきか |
つまり、Agent Swarmを増やしただけで、永続的な知識ベースが自動的に育つわけではありません。出力契約と統合処理を後段に用意して初めて、過去の実行が次回の実行を賢くします。
最小の知識モデル:まず6種類のノードで始める
知識グラフという言葉から、巨大なオントロジーや専用DBを想像するかもしれません。しかし最初の検証では、次の6種類で十分です。
1. Run:1回の実行
いつ、どの目的でAgent Swarmを起動したかを表します。プロンプト、開始・終了時刻、使用モデル、承認範囲、費用や使用量の概算を属性として持たせます。同じテーマを翌月に再調査したとき、差分の基準になります。
2. Agent:担当エージェント
サブエージェントのID、役割、担当範囲を表します。重要なのは「優秀な人格」を作ることではなく、どの成果がどの担当範囲から生まれたかを追えることです。
3. Source:根拠資料
URL、文書、データセット、API応答、画像などの一次・二次情報です。取得日時、公開者、文書更新日、コンテンツハッシュを持たせます。同じURLでも内容が更新されたら別バージョンとして扱えるようにします。
4. Claim:検証可能な主張
「製品Aは機能Xを提供する」「料金は月額Y円」「会社Bが会社Cを買収した」のように、真偽や時点を確認できる文です。主張には、対象期間、確信度、抽出方法、支持するSource、反証するSourceを結び付けます。
5. Entity:人・組織・製品・技術・場所
複数の文書に別表記で登場する同一対象です。「Moonshot AI」「MoonshotAI」「月之暗面」のような表記差を、同じEntityへ解決できれば、文書をまたぐ接続が生まれます。自動統合の確信が低い場合は、別ノードのままpossible_same_asで結び、人間レビューへ回します。
6. Artifact:最終成果物
レポート、記事、表、コード、スライド、動画台本などです。どのClaimとSourceから作られたか、誰がレビューしたか、公開済みかを保持します。これにより「この結論の根拠が変わったので、影響を受ける記事を再確認する」といった逆引きができます。
W3CのPROV-Oは、来歴表現の出発点としてEntity、Activity、Agentを定義し、used、wasGeneratedBy、wasDerivedFrom、wasAssociatedWithなどの関係を提供しています。独自形式から始めても構いませんが、この考え方に寄せておくと、成果物・処理・担当主体の区別が崩れにくくなります(W3C PROV-O)。
エッジには「関係名」だけでなく根拠を持たせる
ノードの種類を増やすより、エッジの品質を上げる方が効果的です。最低限、次の関係を用意します。
| 関係 | 例 | 用途 |
|---|---|---|
produced |
Agent → Artifact | 誰が何を作ったか |
cites |
Claim → Source | 主張の根拠 |
about |
Claim → Entity | 何についての主張か |
supports |
Source → Claim | 支持する証拠 |
contradicts |
Claim → Claim | 主張の衝突 |
derived_from |
Artifact → Claim | 成果物の由来 |
same_as |
Entity → Entity | 同一実体の確定 |
possible_same_as |
Entity → Entity | 要レビューの同一候補 |
depends_on |
Entity → Entity | 技術・取引・運用上の依存 |
各エッジには、source_id、observed_at、confidence、extractor、review_statusを付けます。「A社はB社に依存する」という線だけでは、後から信頼性を判断できません。どの資料のどの箇所から得たか、いつの情報か、LLM抽出か人間確認済みかが必要です。
特にsame_asは慎重に扱います。誤って2社を統合すると、その後のすべての集計が汚染されます。完全一致する法人番号や公式ドメインがある場合は自動確定し、名称の類似だけなら候補に留めるなど、関係ごとに承認ルールを変えるべきです。
実装パイプラインは6段階に分ける
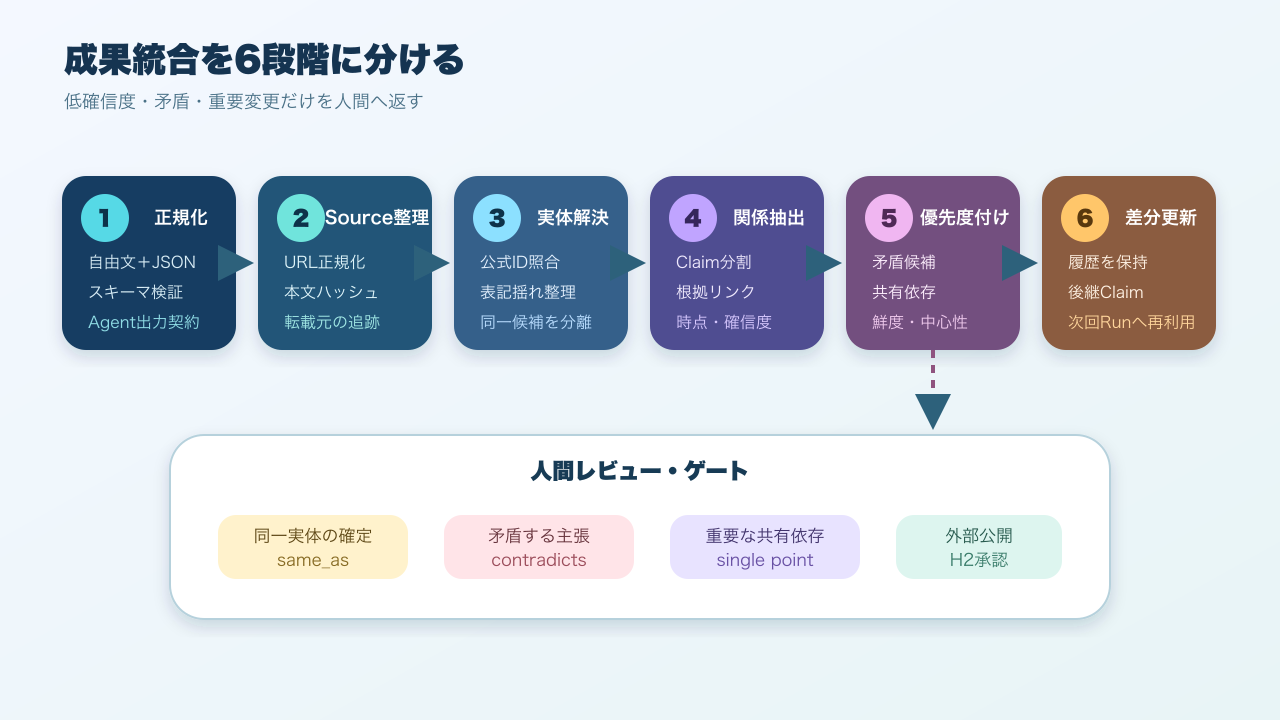
本文図2:収集からグラフ更新までを分離し、確信度が低い接続だけ人間レビューへ送る。
ステップ1:エージェント出力をJSONへ正規化する
最初から自由形式のレポートだけを返させると、後処理が不安定になります。文章の成果物とは別に、各サブエージェントへ次の構造化出力を要求します。
{
  "agent_id": "research-042",
  "task": "公式仕様の確認",
  "sources": [
    {
      "url": "https://example.com/docs",
      "publisher": "Example Inc.",
      "retrieved_at": "2026-08-16T10:00:00+09:00"
    }
  ],
  "claims": [
    {
      "text": "製品Aは機能Xを提供する",
      "entity_mentions": ["製品A", "機能X"],
      "source_url": "https://example.com/docs",
      "confidence": 0.92
    }
  ],
  "artifacts": ["report-042.md"]
}
人が読む説明と、機械が統合するJSONを両方返すのが実用的です。構造化部分では必須項目、最大長、日時形式、確信度範囲をスキーマで検証します。
ステップ2:Sourceを正規化・重複排除する
URLの末尾スラッシュ、追跡パラメータ、短縮URLが違うだけで別Sourceになるのを防ぎます。正規URLに加え、取得した本文のハッシュを保存します。同じ内容を転載した複数URLは別Sourceとして残しつつ、derived_fromやmirrorsで結びます。
「3つのサイトが同じことを言っている」ように見えて、すべて同じプレスリリースの転載だった、という状況を検出できるからです。根拠の数ではなく、独立性を評価できます。
ステップ3:Entity Resolutionを行う
名称を正規化し、公式ID、ドメイン、所在地、親組織などを比較します。判定は三段階にすると安全です。
same_as:公式IDなどで同一と確定possible_same_as:高い類似だが人間確認が必要- separate:別Entityとして維持
LLMに「同じですか」と一度聞くだけではなく、判定理由と使用した属性を残します。次回同じ候補が出たとき、判断を再利用できます。
ステップ4:Claimと関係を抽出する
主張は一文一事実を基本に分けます。「A社は2026年に製品Xを公開し、価格はY円で、B社の技術を利用する」を1ノードにすると、価格だけ更新された場合の扱いが難しくなります。公開、価格、依存の3Claimへ分け、それぞれ時点と根拠を持たせます。
Microsoft GraphRAGの標準インデックスも、文書をTextUnitへ分け、エンティティ、関係、任意の主張を抽出し、コミュニティ検出と要約を行います。出力のRelationshipにはsource、target、description、weight、text_unit_idsがあり、関係を原文断片へ戻せます(GraphRAG Overview、GraphRAG Outputs)。
ステップ5:矛盾と重要接続をスコアリングする
すべてのエッジを人に見せると、結局また大量の一覧になります。レビュー対象を絞るため、次のようなスコアを付けます。
- 複数のArtifactへ影響するEntityは重要度を上げる
- 異なるRunから同じ依存先へ到達したら注目度を上げる
- 同一Entityに対して値が異なるClaimがあれば矛盾候補にする
- 期限切れ・取得日が古いSourceに依存するClaimを鮮度警告にする
- 媒介中心性が高いノードを単一障害点候補にする
- 低確信度なのに公開成果物へ使われる関係を優先レビューへ送る
ここで重要なのは、スコアを真実判定に使わないことです。スコアは「人が先に見るべき候補」を並べるためのものです。
ステップ6:差分としてグラフを更新する
毎回グラフを作り直すと、過去の判断と変化が消えます。新しいRunでは、既存Entityを参照し、新しいSourceとClaimを追加し、古いClaimを削除せずsuperseded_byで後継へつなぎます。
例えば価格改定なら、旧価格は「誤り」ではなく「以前の時点では有効」かもしれません。valid_fromとvalid_toを持たせれば、現在値と履歴を両立できます。知識グラフが「賢くなる」とは、ノード数が増えることではなく、新しい観測が過去の判断をどう更新したか説明できることです。
NetworkXで試す最小実装
専用グラフDBを導入する前に、PythonとNetworkXで価値を確かめられます。以下は、エージェント、根拠、主張、対象、成果物を有向グラフへ追加し、複数成果物が依存するEntityを探す最小例です。
from __future__ import annotations

from collections import defaultdict
from typing import Any

import networkx as nx

def add_result(graph: nx.MultiDiGraph, result: dict[str, Any]) -> None:
    agent_id = f"agent:{result['agent_id']}"
    graph.add_node(agent_id, kind="Agent")

    for source in result["sources"]:
        source_id = f"source:{source['url']}"
        graph.add_node(
            source_id,
            kind="Source",
            publisher=source.get("publisher"),
            retrieved_at=source["retrieved_at"],
        )

    for index, claim in enumerate(result["claims"]):
        claim_id = f"claim:{result['agent_id']}:{index}"
        graph.add_node(
            claim_id,
            kind="Claim",
            text=claim["text"],
            confidence=claim["confidence"],
        )
        source_id = f"source:{claim['source_url']}"
        graph.add_edge(claim_id, source_id, relation="cites")

        for name in claim["entity_mentions"]:
            entity_id = f"entity:{name.casefold()}"
            graph.add_node(entity_id, kind="Entity", label=name)
            graph.add_edge(claim_id, entity_id, relation="about")

    for artifact in result["artifacts"]:
        artifact_id = f"artifact:{artifact}"
        graph.add_node(artifact_id, kind="Artifact")
        graph.add_edge(agent_id, artifact_id, relation="produced")

def shared_entities(graph: nx.MultiDiGraph) -> list[tuple[str, int]]:
    entity_claims: dict[str, set[str]] = defaultdict(set)
    for source, target, data in graph.edges(data=True):
        if data.get("relation") == "about":
            entity_claims[target].add(source)
    return sorted(
        ((entity, len(claims)) for entity, claims in entity_claims.items()),
        key=lambda item: item[1],
        reverse=True,
    )

graph = nx.MultiDiGraph()
# add_result(graph, validated_agent_output)
print(shared_entities(graph)[:10])NetworkXのMultiDiGraphは、同じ2ノード間に複数種類の有向エッジを持てるため、supportsとcontradictsのような関係を並存させやすい選択です。ノードとエッジには任意の属性も付けられます(NetworkX DiGraph公式ドキュメント)。
ただし、この例のEntity Resolutionはcasefold()だけなので、本番用途には不十分です。まず少数データで「どの接続が役に立つか」を確認し、その後に正規化辞書、公式ID照合、埋め込み類似度、人間レビューを加えます。
GraphRAGを使う場合と、自作する場合
大量の非構造文書からエンティティ・関係・コミュニティ要約を作り、全体傾向を質問したいなら、GraphRAGは有力な選択肢です。Microsoftの標準パイプラインは、抽出、エンティティと関係の要約、コミュニティ検出、コミュニティレポート生成までを扱います。高速・低コスト寄りのFastGraphRAGでは、一部のLLM推論をNLPによる名詞句抽出や共起関係へ置き換えます(GraphRAG Methods)。
一方、Agent Swarmの運用管理では、GraphRAGだけでは不足する場合があります。記事や調査内容の意味グラフに加え、「どのRunで」「どのAgentが」「どの承認範囲で」「何を生成したか」という実行グラフも必要だからです。
おすすめは、次のように分ける構成です。
- GraphRAG:文書内部のEntity、Relationship、Claim、Communityを抽出
- 運用メタデータ:Run、Agent、Task、Approval、Artifactを独自スキーマで保持
- Provenance接続:SourceとArtifactを
used、wasGeneratedBy相当の関係で結ぶ - レビュー画面:矛盾、単一障害点、古い根拠、低確信度の接続だけ提示
最初からGraphRAGを全データへかける必要はありません。公式Getting Startedも、小さなチュートリアルデータと安価なモデルから試すことを勧めています。対象文書が少ない段階では、構造化出力とルールベースの同一実体解決だけの方が、費用もデバッグ負荷も小さくなります。
ダッシュボードで見るべきもの
グラフを作っても、ノードと線をそのまま全面表示すると読みにくくなります。運用ダッシュボードでは、目的別にビューを分けます。処理手順自体を整理したい場合は、先に「Markdownでフローチャートの作り方 入門編(Mermaid)」のようなフロー図で責務を整理してから、関係探索用のグラフビューを作ると混乱が減ります。
日次ビューには実行中Run、失敗したAgent、矛盾Claim、同一実体の確認待ち、外部公開前のArtifactを置きます。月次ビューでは再利用されたSourceとClaim、複数プロジェクトにまたがるEntity、古い根拠、使用量とレビュー件数の推移を見ます。リスクビューは、多数のArtifactが依存する単一Entityや、同じ一次情報から派生した見かけ上の複数Sourceを優先します。
「1つの巨大な地図」を常に見せるより、問いに応じて部分グラフを切り出す方が実用的です。全体マップは探索用、レビュー一覧は判断用、時系列は運用改善用と役割を分けます。
自動化の境界:止まるべき場所を先に決める
半自動運用では、どこまで自動で進め、どこで人間に返すかを先に決めます。おすすめの境界は次の通りです。
自動で進めやすい処理
- 公式情報の収集候補を広く探す
- URLと本文ハッシュを正規化する
- JSONスキーマを検証する
- Entityと関係の候補を抽出する
- 重複、矛盾、鮮度低下の候補をスコアリングする
- ローカルの下書き、図、レビュー資料を作る
人間確認を残す処理
- 同一実体の確定で影響が大きいもの
- 法務、医療、金融など高リスク領域の結論
- 個人情報や非公開情報の利用
- 有料APIの大規模実行や予算変更
- 外部への送信、公開、予約投稿
- 既存の公開物の削除・大幅変更
重要なのは、Agent数ではなく操作の影響で承認レベルを決めることです。300エージェントがローカルに候補を作る処理は自動化できても、1エージェントが公開ボタンを押す処理は人間承認が必要です。
失敗しやすい設計と対策
よくある失敗は、文書をベクトルDBへ入れただけで終えることです。類似検索と、確定した依存・矛盾・来歴を保持するグラフは併用します。また、関係をLLMへ無制限に抽出させると名称が揺れるため、最初はcites、about、derived_from、same_as、depends_onなどに限定します。
Entityの早すぎる統合にも注意が必要です。同名企業やブランド変更で誤統合が起きるため、確定と候補を分け、統合操作を監査ログへ残します。価格や仕様は上書きせず、有効期間と後継関係を持たせます。成功指標もノード数ではなく、重複調査の削減、公開前の矛盾発見、過去成果の再利用率で測ります。
まず1週間で作る最小版
本格導入前に、1テーマ・10〜20エージェント・50Source程度で試します。
前半で出力JSONと6種類のノードを決め、小さな調査から構造化出力を集めます。後半でURL正規化、Entity候補生成、NetworkX取り込み、人間レビュー、2回目Runの差分追加まで試します。最後に「グラフがなければ見落としていた接続が1つ以上あったか」を評価します。
最小版の成功条件は、華麗な可視化ではありません。
- 1つのClaimから根拠Sourceへ戻れる
- 1つのArtifactから利用Claimを逆引きできる
- 同一Entityを扱った複数Agentの成果をまとめて見られる
- 矛盾または重要な共有依存を1件以上提示できる
- 次のRunが過去のEntityを再利用できる
これを満たした後で、GraphRAG、グラフDB、コミュニティ検出、ダッシュボードを段階的に足せば十分です。
まとめ:答えの数ではなく、次回に残る接続を増やす
Agent Swarmは、広い探索空間を短時間でカバーする強力な実行方式です。しかし、成果をフォルダへ積むだけでは、次の調査でまた同じ資料を読み、同じ対象を照合し、同じ矛盾を探すことになります。
知識グラフへ統合すると、各回答は単独の文書ではなく、根拠・主張・対象・成果物の接続として残ります。別々のエージェントが同じEntityへ到達したとき、線が生まれます。複数の成果物が同じ外部サービスへ依存しているとき、単一障害点候補が浮かびます。古いSourceが更新されたとき、影響を受けるArtifactを逆引きできます。
目指すべきは「300の答えを一度に読むシステム」ではありません。300の探索から、人間が見るべき10の接続を取り出し、その判断を次回へ引き継ぐシステムです。
最初の一歩は小さくて構いません。次回のエージェント実行に、自由形式レポートと一緒にSource・Claim・Entity候補のJSONを返させてください。その1回分をNetworkXへ読み込み、複数の成果に共通するEntityを並べるだけでも、「文書の山」から「育つ地図」への変化を確認できます。
調査に使った一次情報の完全な一覧と確認日は、同梱のresearch.mdへ記録しています。

コメント