「今いちばん性能が高いAIモデルはどれだろう」と調べると、Chatbot ArenaやLMArenaという名前を目にすることがあります。一方、公式サイトを開くと現在の名称はArenaです。ページには多数のモデル、Score、Rank Spread、Votes、価格、Contextなどが並び、単純に1位だけ見ればよいのか迷いやすくなっています。
Arenaは、同じプロンプトに対する2つの匿名回答を人が比較し、好ましい方へ投票することでAIモデルを評価するサービスです。2023年にChatbot Arenaとして始まり、LMArenaを経て、2026年1月からArenaという名称になりました。現在は一般的なテキスト生成だけでなく、コード、画像理解、文書、検索、画像生成、動画、エージェントなど、用途別のLeaderboardが用意されています。
この記事では、Arenaの最新の名称と仕組み、Battle Modeの使い方、LeaderboardのScore・信頼区間・Rank Spreadの読み方を整理します。2024年時点の固定Top10を並べるのではなく、変化し続けるランキングを自分の用途に合わせて判断する方法を解説します。
この記事の結論
- Chatbot Arena、LMArena、Arenaは同じ系譜のサービスで、現在の公式名称はArena
- 公開Leaderboardを動かすのは、モデル名を隠したBattle Modeの投票
- 1位だけでなく、用途別Arena、Scoreの信頼区間、Rank Spread、Votesを一緒に見る
- Arenaの順位は「人に好まれた回答」の指標であり、正確性や安全性を単独で保証しない
- 最終選定では、自分の実務プロンプトを使ったSide by Side比較を組み合わせる
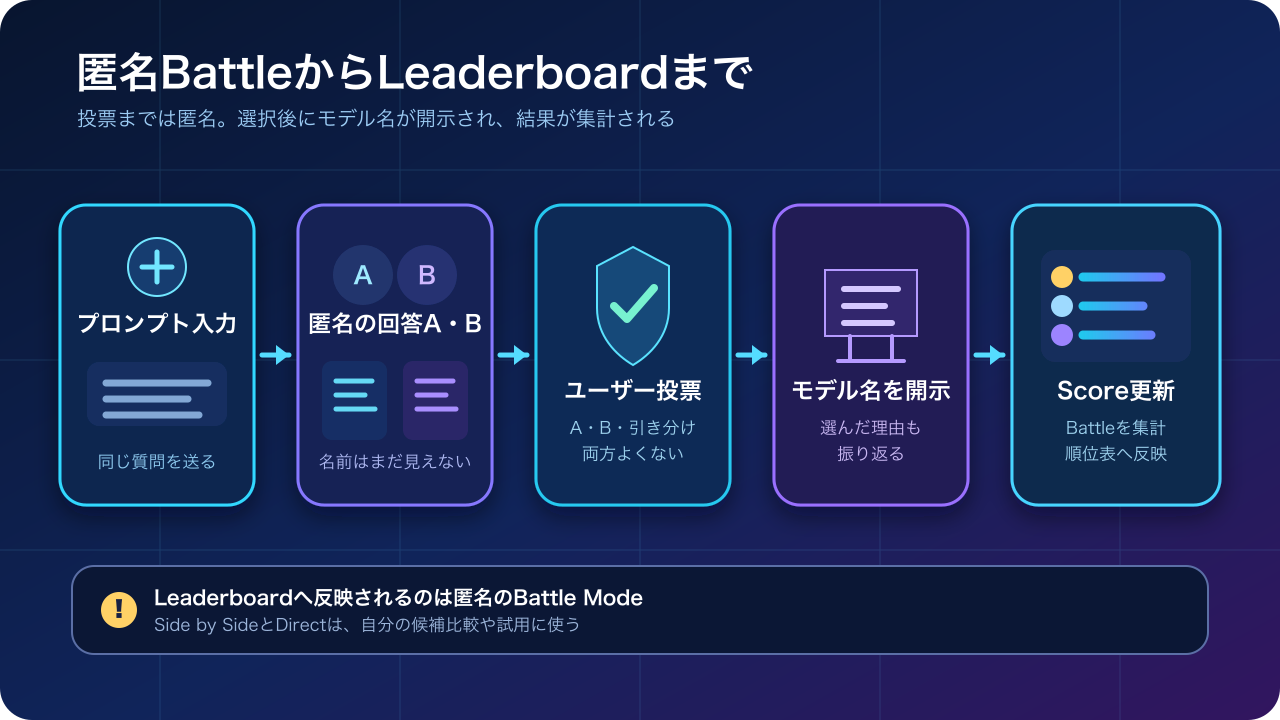
図1:匿名の2モデルへ同じプロンプトを送り、投票後にモデル名を開示する。Battleの集積がLeaderboardを更新する。
Chatbot Arena、LMArena、Arenaは何が違う?
最初に名称を整理しておきましょう。
| 時期 | 主な名称 | 意味 |
|---|---|---|
| 2023年〜 | Chatbot Arena | UC BerkeleyのLMSYSを起点に始まった、LLMの匿名対戦型評価プラットフォーム |
| その後 | LMArena | 言語モデル比較の枠を広げ、コミュニティ主導の評価基盤として発展した名称 |
| 2026年1月〜 | Arena | 言語だけでなく、コード、画像、動画、検索、エージェントなどへ対象を広げた現在の公式名称 |
Arena公式は2026年1月28日、LMArenaからArenaへ名称を変更し、公式サイトを arena.ai へ移行したと説明しています。Chatbot Arenaという旧名称が間違いになったわけではありません。研究プロジェクトや評価方式の歴史を示す言葉として残っており、論文、GitHub、検索結果では今もChatbot ArenaやLMSYSという表記が見つかります。
したがって、情報を探すときは次の対応関係で考えると迷いません。
- 現在のサービスを使う:Arena
- 旧サービス名や2025年頃の資料を探す:LMArena
- 匿名Battle方式の原点や2023〜2024年の論文を探す:Chatbot Arena、LMSYS
本記事では現在のサービスをArenaと呼び、旧名称を説明するときだけLMArena・Chatbot Arenaを使います。
なお、当サイトでは2024年6月時点のLMSYS Chatbot Arena Leaderboardも記録しています。当時の主要モデルや順位を振り返りたい場合は旧記事を参照してください。本記事では特定時点の順位を保存するのではなく、現在のArenaを使い、変動するLeaderboardを自分で読み解く方法に焦点を当てます。
Arenaとは?人間の好みでAIモデルを比べる評価基盤
一般的なAIベンチマークでは、あらかじめ用意した問題へモデルが回答し、正解率や自動評価スコアを計算します。再現しやすい一方で、問題が固定されているため、現実のユーザーが日々入力する多様な依頼を完全には表せません。
Arenaは、実際のユーザーが入力したプロンプトへ2モデルが回答し、人が好ましい方を選ぶ一対比較を集めます。モデル名は投票まで隠されるため、特定の会社名やモデルブランドに引っ張られにくい設計です。投票後にモデル名が表示され、匿名Battleの結果が公開Leaderboardへ集約されます。
この方式の強みは、評価対象が固定問題だけに閉じないことです。文章作成、プログラミング、相談、要約、創作、検索など、利用者が実際に試したい課題が評価データになります。新しいモデルを継続的に追加し、対戦結果を積み上げられる点も、変化が速い生成AIと相性がよい部分です。
一方、人間の投票は「正解か不正解か」だけを見ているとは限りません。詳しくて読みやすい文章、丁寧な口調、見栄えのよいMarkdown、長い回答が好まれる場合があります。この特性を理解し、Arenaを万能な真実判定器ではなく、現実の利用者がどちらの応答を好んだかを測る重要な一指標として使うことが大切です。
Battle Modeの使い方
Arenaの中心はBattle Modeです。基本の流れは5段階です。
1. 比較したい用途を選ぶ
公式サイトで、Text、Search、Code、Imageなど比較したいArenaを選びます。一般的な会話や文章作成ならText、ウェブ検索を伴う回答ならSearch、画像理解ならVisionというように、実際の用途に近いArenaへ入ります。
2. プロンプトを入力する
普段AIへ依頼したい内容を入力します。評価しやすくするには、「旅行プランを作って」よりも、条件と完了形を具体的にした方がよいでしょう。
例えば、次のようにします。
- 対象読者と目的を指定する
- 必須条件を3〜5個に絞る
- 出力形式を表や手順に指定する
- 正確性、簡潔さ、実行可能性など評価基準を決める
ただし、機密情報、個人情報、未公開資料、APIキー、顧客データは入力しないでください。Arenaではプロンプトや投票などが研究やサービス改善に利用され、モデル提供者と共有されたり、匿名化したデータとして公開されたりする可能性があります。
3. 匿名の回答AとBを比較する
同じプロンプトに対して、匿名の2モデルが回答します。ブランド名を予想するより、事前に決めた基準で内容を比べます。
- 指示をすべて満たしているか
- 事実関係に不自然な点がないか
- 必要な情報が抜けていないか
- 冗長すぎず、実際に使えるか
- コードなら安全性と実行可能性があるか
4. 好ましい回答へ投票する
回答A、回答B、引き分け、両方よくない、などから判断します。確信がなければ無理に優劣をつける必要はありません。専門知識が必要な質問では、根拠を確認せずに流暢さだけで投票しないよう注意します。
5. モデル名を確認する
投票後にモデル名が開示されます。結果が予想と違った場合は、なぜ片方を選んだのかを振り返ると、自分が重視する特性を理解できます。
Battle、Side by Side、Directの違い
Arenaには似た画面が複数ありますが、目的が異なります。
| モード | モデル名 | 主な目的 | 公開Leaderboardへの反映 |
|---|---|---|---|
| Battle | 投票まで匿名 | 先入観を抑えて2モデルを評価する | 反映される |
| Side by Side | 自分で2モデルを選ぶ | 候補モデルを同じ条件で詳しく比較する | 反映されない |
| Direct | 1モデルを選ぶ | 特定モデルを通常のチャットとして試す | 反映されない |
Leaderboardへ貢献したいならBattleを使います。自分が導入するモデルを決めたいなら、Leaderboardで候補を絞った後、Side by Sideで実務プロンプトを比較する流れが実用的です。
DirectとSide by Sideで入力したプロンプトや選択結果も研究目的で収集される場合があります。「Leaderboardへ反映されない」ことと「データが収集されない」ことは別なので注意してください。
Arena Leaderboardは用途別に選ぶ
現在のArenaは、すべてのAIを1枚の総合表だけで比べるサービスではありません。公式Leaderboardには複数のArenaがあり、用途ごとに評価対象が分かれています。
代表例は次の通りです。
| Arena | 主に確認できること |
|---|---|
| Text | 一般的な文章生成、対話、推論などの人間選好 |
| Agent | ツール利用や複数ステップを含むエージェント的な実行 |
| Code / WebDev | コード生成、ウェブ開発、実装結果 |
| Vision | 画像を入力した理解、説明、推論 |
| Document | 文書読解や長いコンテンツの処理 |
| Search | ウェブ検索を伴う情報取得と回答 |
| Text-to-Image | テキスト指示からの画像生成 |
| Image Edit | 画像編集指示への追従と仕上がり |
| Video | テキストや画像からの動画生成・編集 |
「総合1位だからコードも検索も最適」とは限りません。ブログ執筆ならText、ウェブの最新情報を調べるならSearch、アプリ制作ならCodeやWebDevというように、自分の作業と同じArenaを優先します。
さらに、Leaderboardによっては言語、タスク、ライセンス、Style Controlなどのフィルタがあります。総合表だけでなく、実際に使う条件へ絞った順位も確認してください。
Score、信頼区間、Rank Spreadの読み方
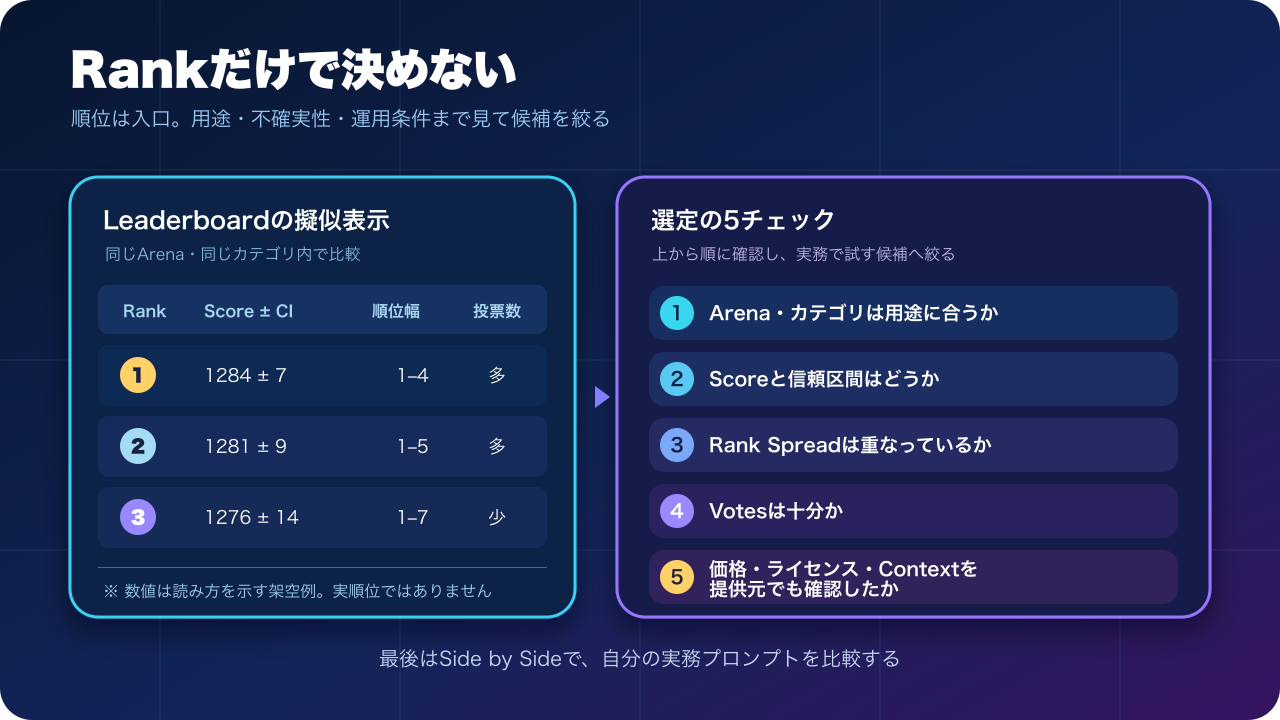
図2:Rankだけで決めず、用途、Scoreの不確実性、Rank Spread、Votes、運用条件を組み合わせて読む。
Arenaの表を読むときは、少なくとも5項目を一緒に見ます。
Rank:Score順の現在推定順位
現在の公式方式では、raw rankはArena Scoreの順に一意に付けられます。表の並びを把握するには便利ですが、1位と2位に統計的な明確な差があるとは限りません。
Score:一対比較結果から計算した相対評価
Arenaは、モデルAとBのどちらが選ばれたかという多数の一対比較をBradley-Terry系のモデルへ集約します。Scoreは絶対的な正解率ではなく、対戦相手や投票結果から推定する相対的な強さです。
異なるArenaのScoreを単純比較しないでください。TextのScoreとVisionのScoreは、評価対象も投票データも異なります。同じLeaderboard、同じカテゴリの中で見るのが基本です。
±の値・信頼区間:推定の不確実性
Scoreの横に表示される±の値は、推定値の不確実性を表します。Battle数が少ない新しいモデルでは範囲が広くなりやすく、投票が増えると安定していきます。
Scoreが数ポイント違っても信頼区間が大きく重なるなら、「順位は違うが、現時点で明確な差があるとは言いにくい」と解釈するのが安全です。
Rank Spread:あり得る順位の幅
Rank Spreadは、各モデルの信頼区間を使って計算する順位の範囲です。公式の説明では、自分に最も有利で他モデルに不利な値を仮定した順位と、その逆の悲観的な順位を範囲として示します。
例えばraw rankが3でも、Rank Spreadが「1〜5」なら、データの不確実性を考慮すると1位候補にも5位候補にもなり得ます。複数モデルのRank Spreadが重なっている場合、それらは実質的な同順位候補として扱う方が現実的です。
Votes:比較に参加した量
Votesが多いほど必ず正しいわけではありませんが、推定の安定性を判断する材料になります。新モデルの高順位を見るときは、ScoreだけでなくVotesと信頼区間を確認します。
Bradley-Terryモデルとは?
Bradley-Terryモデルは、2者のどちらが勝つかという一対比較から、それぞれの相対的な強さを推定する統計モデルです。Arenaでは多数の「モデルAとモデルBのどちらを好んだか」を集計し、各モデルのScoreと信頼区間へ変換します。
重要なのは、全モデルが同じ回数だけ総当たりする必要がないことです。異なる組み合わせのBattleをつなぎ、全体の相対順位を推定できます。Arena公式は現在のLeaderboard計算方法をarena-rankとして公開しており、Bradley-Terry、比較数が少ないモデルへの調整、信頼区間計算などを確認できます。
ただし、統計モデルが精密でも、入力となる投票が何を評価しているかは別問題です。人が読みやすさを重視すれば読みやすいモデルが上がり、創造性を重視する利用者が多ければ創造的なモデルが上がります。Scoreは「モデルの全能力を1つの真値で表したもの」ではなく、集まったBattleと人間選好の要約です。
Style Controlはなぜ必要?
同じ内容でも、長く丁寧な回答、見出しや太字が多い回答、感情表現のある回答が好まれることがあります。Arena公式のStyle Control分析では、回答の長さやMarkdown表現を調整すると、モデルの順位が変化することが示されました。
Style Controlは、Bradley-Terry回帰へ回答長、Markdown見出し、太字、リストなどの特徴を加え、表現スタイルの影響を分けて見ようとする方法です。
通常のLeaderboardとStyle Controlは、どちらか一方だけが正しいわけではありません。
- 通常順位:人が実際に好んだ完成回答を知りたい
- Style Control:文章の長さや装飾を差し引き、内容面の傾向を見たい
接客文章やブログ下書きではスタイルも品質の一部です。一方、短い正答や簡潔なコードを求める場合は、通常順位だけで長文モデルを選ぶと合わない可能性があります。用途に応じて両方を確認します。
Arenaの順位だけで「最強AI」を決められない5つの理由
1. 人間選好と事実の正しさは同じではない
もっともらしく読みやすい誤答が、短く慎重な回答より選ばれることがあります。医療、法律、金融、研究、最新ニュースでは、Arena順位とは別に一次情報と専門的な検証が必要です。
2. 得意分野が平均化される
総合順位は多様なプロンプトの平均です。日本語、SQL、フロントエンド、長文読解など、自分の用途ではカテゴリ別順位や個別テストの方が参考になります。
3. 新モデルは不確実性が大きい
公開直後のモデルはVotesが少なく、信頼区間やRank Spreadが広い場合があります。raw rankだけで即決せず、データが増えた後の変化も確認します。
4. 価格・速度・利用条件は別軸
高Scoreでも、料金、応答速度、利用上限、データ保持、API提供地域、ライセンスが要件に合わない場合があります。Leaderboardに価格やContextが表示される場合もありますが、契約前は必ず各提供元の公式情報を確認してください。
5. モデル名とバージョンが変わる
同じブランドでも、日付付きバージョン、推論設定、プレビュー版、提供終了モデルが混在します。Arenaはモデルの追加・廃止や方法変更をLeaderboard Changelogで公開しているため、記事に転記された古いTop10より公式のライブ表を優先します。
自分に合うAIを選ぶ実践手順
Arenaを導入判断へ使うなら、次の順序がおすすめです。
ステップ1:用途に対応するArenaを選ぶ
文章ならText、検索ならSearch、実装ならCode、画像理解ならVisionのように対象を合わせます。
ステップ2:Rank Spreadまで見て3モデルへ絞る
raw rankの上位から、Rank Spreadが重なる候補を2〜3モデル残します。1位だけを残す必要はありません。
ステップ3:価格・ライセンス・Contextを確認する
入力単価、出力単価、オープンウェイトか、必要なContextを満たすか、利用規約が業務用途に合うかを確認します。表示値は更新され得るため、契約や実装前にモデル提供元でも再確認します。
ステップ4:Side by Sideで実務プロンプトを試す
普段使う10〜20件のプロンプトを準備し、候補モデルを同じ条件で比べます。機密データは架空値へ置き換えます。
ステップ5:評価基準を固定する
次のような基準を5段階で記録します。
- 指示への追従
- 事実性と根拠
- 読みやすさ
- 修正の少なさ
- 応答速度
- 料金
- 安全性とデータ利用条件
ステップ6:複数モデルの使い分けも検討する
すべてを1モデルへ統一せず、調査、執筆、コード、画像でモデルを使い分ける方法もあります。Arenaは「唯一の勝者」を決めるだけでなく、用途ごとの候補を探す地図として使う方が実用的です。
よくある勘違いとトラブル
「LMSYSのサイトがなくなった?」
サービスの系譜がChatbot Arena、LMArena、Arenaへ変わりました。現在の公式入口は arena.ai です。古い論文やGitHubではLMSYSやChatbot Arenaの表記が残っています。
「Side by Sideで投票したのに順位が変わらない」
公開Leaderboardへ反映されるのは匿名のBattle Modeです。Side by Sideは比較するモデルが見えているため、公開順位の投票には使われません。
「1位と2位は明確に性能差がある?」
必ずしもそうではありません。Scoreの信頼区間とRank Spreadが重なる場合、raw rankは違っても統計的には同順位候補です。
「Arena Scoreが高ければ事実も正しい?」
Arena Scoreは主に人間の比較選好を集約した相対指標です。事実性は別途検証が必要です。Searchなど一部のLeaderboardには追加の調整指標が提供される場合がありますが、高リスク用途では一次情報確認を省略できません。
「記事に載っているTop10を使えばよい?」
モデルと順位は短期間で変わります。固定表は確認日を過ぎると急速に古くなるため、最新順位は必ず公式Leaderboardで確認してください。本記事がTop10の固定転載をやめたのもこのためです。
利用前チェックリスト
- □ Chatbot Arena、LMArena、Arenaが同じ系譜だと理解した
- □ 自分の用途に対応するArenaを選んだ
- □ raw rankだけでなくScoreの信頼区間とRank Spreadを見た
- □ Votesが少ない新モデルを暫定評価として扱った
- □ Style Controlなど利用可能な調整表示を確認した
- □ 価格、速度、ライセンス、Contextを別に確認した
- □ Side by Sideで実務プロンプトを比較した
- □ 機密情報、個人情報、APIキーを入力していない
- □ 正確性が重要な回答を一次情報で検証した
- □ 最新順位は公式Leaderboardで確認した
まとめ:1位を探すより、自分の用途に合う候補を絞る
Arenaは、実際のユーザーが2つの匿名回答を比べた結果を集め、AIモデルの相対的な評価を公開するプラットフォームです。Chatbot Arenaとして始まり、LMArenaを経て、現在はArenaという名称で言語、コード、画像、検索、動画、エージェントなどへ対象を広げています。
Leaderboardを見るときは、raw rankだけで判断せず、次の順で確認してください。
- 自分の用途に合うArenaとカテゴリ
- Scoreと信頼区間
- Rank SpreadとVotes
- Style Controlなどの調整表示
- 価格、速度、Context、ライセンス
- 自分の実務プロンプトによるSide by Side比較
Arenaの価値は、すべてのAIへ永久的な順位を付けることではありません。変化し続けるモデル群から、今試すべき候補を絞り、人間の実利用に近い比較を始められることです。最新の順位は記事内の固定表ではなく、Arena公式Leaderboardで確認してください。
関連記事
- 2024年6月時点のLMSYS Chatbot Arena Leaderboard
- Kimi Agent Swarmとは?最大300エージェントで調査・制作を並列化
- ローカルLLMまとめ(2024年5月下旬)
- LLM Scraperとは?
公式資料
- Arena公式:LMArena is now Arena
- Arena公式:How It Works
- Arena公式:Leaderboard
- Arena公式:Ranking Method
- Arena公式:Arena-Rank
- Arena公式:Style Control
- Arena公式FAQ
- Chatbot Arena論文
公式情報の確認日:2026年8月16日。名称、Leaderboard、利用条件、データ取扱いは変更される可能性があります。
コメント