CSVをPandasやPolarsで読み込んだものの、ファイルが大きくなるとメモリ不足になったり、必要な列が少ないのに読み込みが遅かったりすることがあります。処理の順番をPythonコードに書いた通り実行すると、フィルタする前の全データをメモリへ載せ、使わない列まで読み込むことになりがちです。
PolarsのLazyFrameは、処理をすぐ実行せず、クエリとして組み立ててから最適化し、最後にまとめて実行する仕組みです。scan_csv()で入力を遅延読み込みし、filter()、select()、group_by()をつないで、collect()で結果を得ます。大きな結果をファイルへ直接書く場合は、streaming engineとsink_parquet()などを組み合わせられます。
この記事では、売上CSVを月別に集計する例を使い、read_csv()との違い、projection pushdownとpredicate pushdown、実行計画の確認、streaming engine、Parquetへの変換、よくある失敗まで解説します。
LazyFrameとは
Polarsには、主にDataFrameとLazyFrameがあります。DataFrameはデータがメモリ上にあり、メソッドを呼ぶたびに処理が実行されます。LazyFrameは処理計画を保持し、collect()やsink_*()を呼ぶまで原則として実行しません。
| 観点 | DataFrame | LazyFrame |
|---|---|---|
| 生成 | pl.read_csv()など |
pl.scan_csv()など |
| 実行タイミング | 各処理を順次実行 | 最後に最適化して実行 |
| 戻り値 | すぐにDataFrame | LazyFrameをつないでいく |
| 主な用途 | 小〜中規模データ、探索 | 大規模処理、定型ETL、最適化 |
| 実行計画 | 基本的に不要 | explain()で確認できる |
| ストリーミング | 処理後に検討 | collect(engine="streaming")やsinkを利用 |
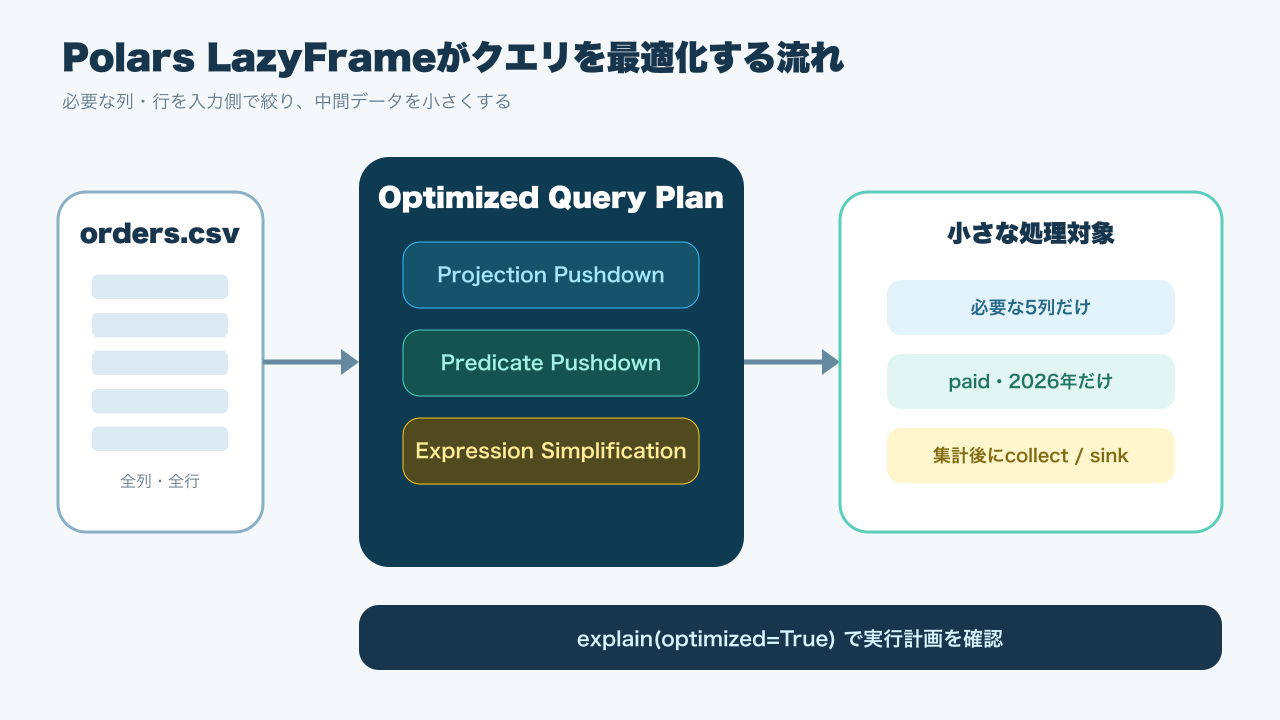
LazyFrameの利点は、書いた処理を単に遅らせるだけではありません。Polarsはクエリ全体を見て、不要な列を読まない、フィルタを入力側へ近づける、式を単純化するといった最適化を行えます。
ただし、Lazy APIへ変えれば必ず速くなるわけではありません。I/O、データ型、圧縮、処理内容、CPU、メモリ量によってボトルネックは異なります。explain()やprofile()で計画と時間を確認し、測定して判断します。
インストールとサンプルデータ
仮想環境へPolarsをインストールします。
python -m venv .venv
source .venv/bin/activate
pip install polarsこの記事では、次の列を持つorders.csvを想定します。
ordered_at,customer_id,category,quantity,unit_price,status
2026-01-03,C001,book,2,1800,paid
2026-01-04,C002,device,1,12800,cancelled
2026-01-08,C003,book,1,2400,paid目的は、2026年のpaidだけを対象に、月・カテゴリ別の売上、注文数、顧客数を集計することです。売上はquantity * unit_priceで計算します。
read_csvとscan_csvの違い
pl.read_csv()は呼び出した時点でCSVを読み込み、DataFrameを返します。
import polars as pl

df = pl.read_csv("orders.csv")
result = (
    df.filter(pl.col("status") == "paid")
    .select("ordered_at", "customer_id", "category", "quantity", "unit_price")
)一方、pl.scan_csv()はLazyFrameを返します。
import polars as pl

query = (
    pl.scan_csv("orders.csv", try_parse_dates=True)
    .filter(pl.col("status") == "paid")
    .select("ordered_at", "customer_id", "category", "quantity", "unit_price")
)

result = query.collect()queryを作った時点では、結果全体はまだDataFrameとしてメモリへ展開されていません。Polarsはcollect()時に、必要な列と行を考慮して処理します。
公式ドキュメントでも、Lazy APIを利用したい場合はread_csv().lazy()ではなくscan_csv()を使うことが推奨されています。read_csv().lazy()はすでにファイル全体を読み込んだ後なので、読み込み段階への最適化を適用できません。
月別売上をLazyFrameで集計する
実用的なクエリを組み立てます。
from pathlib import Path

import polars as pl

def build_monthly_sales_query(csv_path: Path) -> pl.LazyFrame:
    return (
        pl.scan_csv(
            csv_path,
            schema_overrides={
                "customer_id": pl.String,
                "category": pl.String,
                "quantity": pl.Int64,
                "unit_price": pl.Int64,
                "status": pl.String,
            },
            try_parse_dates=True,
        )
        .filter(
            (pl.col("status") == "paid")
            & (pl.col("ordered_at").dt.year() == 2026)
        )
        .with_columns(
            revenue=(pl.col("quantity") * pl.col("unit_price")),
            month=pl.col("ordered_at").dt.truncate("1mo"),
        )
        .group_by("month", "category")
        .agg(
            revenue=pl.col("revenue").sum(),
            orders=pl.len(),
            customers=pl.col("customer_id").n_unique(),
        )
        .sort("month", "category")
    )

query = build_monthly_sales_query(Path("orders.csv"))
monthly_sales = query.collect()
print(monthly_sales)
この関数はDataFrameではなくLazyFrameを返します。呼び出し側は、さらにカテゴリの絞り込みを追加したり、実行計画を確認したり、ファイルへ直接書き出したりできます。
schema_overridesで重要な列の型を指定している点にも注目してください。CSVの型推論は先頭の一定行をもとに行われるため、後ろに異なる値が現れると読み込みエラーや意図しない型になることがあります。IDの先頭ゼロ、金額の整数型、日付形式など、意味が分かっている列は明示すると安定します。
LazyFrameで効く主な最適化
PolarsのLazy APIでは、クエリ全体を見て複数の最適化が適用されます。公式ユーザーガイドには、projection pushdown、predicate pushdown、slice pushdown、common subplan eliminationなどが挙げられています。
Projection pushdown
最終結果で必要な列だけを入力から読む最適化です。CSVに100列あっても、集計で5列しか使わなければ、不要列の解析やメモリ使用を減らせます。
クエリ途中で不要列を明示的にselect()することも読みやすさに役立ちますが、LazyFrameでは最終的に使われる列をPolarsが解析します。
Predicate pushdown
status == "paid"や日付範囲のフィルタを、可能な限り入力側へ近づけます。後段の計算や集計へ渡る行数を早期に減らせます。
Parquetではファイル統計やrow groupを利用して、対象外の部分を読み飛ばせる場合があります。CSVは行単位のテキストなのでParquetほど強力ではありませんが、不要な後続処理を減らす効果はあります。
Slice pushdown
head(100)やlimit(100)のように必要行数が少ない場合、読み込みや処理量を早く打ち切れるよう最適化します。開発中のサンプル確認で有効です。
Expression simplification
式を簡潔な形へ変換し、定数評価や重複処理の削減を行います。Python側で細かいループを書くより、Polars式としてまとめる方が最適化しやすくなります。
explainで実行計画を確認する
LazyFrameはexplain()で実行計画を表示できます。
print(query.explain(optimized=False))
print(query.explain(optimized=True))
最適化前と最適化後を比較すると、どの列が入力で必要と判定されたか、フィルタがどこへ移動したかを確認できます。出力形式はPolarsのバージョンやクエリによって変わるため、文字列の完全一致をテストするより、重要な演算や入出力を目視確認する用途が向いています。
確認したいポイントは次の通りです。
- 入力スキャンで必要列だけが選択されているか
statusや日付の条件がスキャンへ近い位置にあるか- 意図しない全結合や重複計算がないか
- Python UDFが最適化を妨げていないか
- 大きな中間結果を作る順序になっていないか
処理時間を詳しく確認したい場合はprofile()も利用できます。ただし、測定時のファイルキャッシュ、ストレージ、CPU負荷で結果は変わります。同じ環境で複数回測り、代表値を比較します。
streaming engineでメモリ圧力を下げる
通常のcollect()は最終結果をDataFrameとして返します。入力が大きくても最適化で中間データを減らせますが、結果自体が大きければメモリが必要です。
Polarsではengine="streaming"を指定し、対応する演算をバッチ処理できます。
result = query.collect(engine="streaming")旧バージョンの例で見かけるcollect(streaming=True)ではなく、現在の安定版ドキュメントに合わせてengine="streaming"を使います。APIは変化する可能性があるため、導入時に利用中バージョンの公式ドキュメントを確認してください。
streaming engineは、入力や中間結果を小さなバッチで処理し、メモリ圧力を下げられる場合があります。ただし、すべての演算が完全にストリーミングできるわけではありません。全体ソート、特定の結合、最終結果の巨大なDataFrameなどは相応のメモリを必要とします。
「streamingを付ければメモリを一切使わない」と考えず、次の順番で改善します。
- 不要列を減らす
- フィルタを早く適用する
- データ型を適切にする
- 集計して最終結果を小さくする
- streaming engineを試す
- 結果が巨大ならsinkで直接書き出す
collectとsinkの使い分け
最終結果をPythonで操作するならcollect()でDataFrameを得ます。最終目的がParquetやCSVの生成なら、DataFrameへすべて収集せずsink_*()で直接書く方法があります。
query.sink_parquet(
    "monthly_sales.parquet",
    compression="zstd",
    mkdir=True,
)sink_parquet()はストリーミングでクエリを評価してParquetへ書き出します。結果を別の分析処理で使う場合、CSVよりParquetを選ぶと、型情報、圧縮、列指向読み込みの利点があります。
CSVが必要ならsink_csv()も利用できます。
query.sink_csv("monthly_sales.csv", mkdir=True)出力先が既存ファイルの場合の上書き方針、途中失敗時の一時ファイル、処理完了後の原子的な切り替えはアプリ側で設計します。大きなバッチでは、直接本番ファイル名へ書かず、一時パスへ出力して件数とスキーマを検証後に切り替えると安全です。
複数CSVをまとめて読む
日別や月別に分割されたCSVは、globパターンでまとめてscanできます。
query = (
    pl.scan_csv(
        "data/orders/2026-*.csv",
        try_parse_dates=True,
        include_file_paths="source_file",
    )
    .filter(pl.col("status") == "paid")
)include_file_pathsで元ファイルを示す列を追加すると、異常値の発生元を追跡しやすくなります。ファイル間でスキーマが揃っていない場合は、先に入力契約を決め、欠損列や型違いを検出する監査処理を用意します。
大量の小さなCSVは、ファイルを開くオーバーヘッドが大きくなります。一度Parquetへ変換し、適切なサイズのファイルへまとめると、後続の繰り返し分析が速くなることがあります。
CSVをParquetへ変換する実践フロー
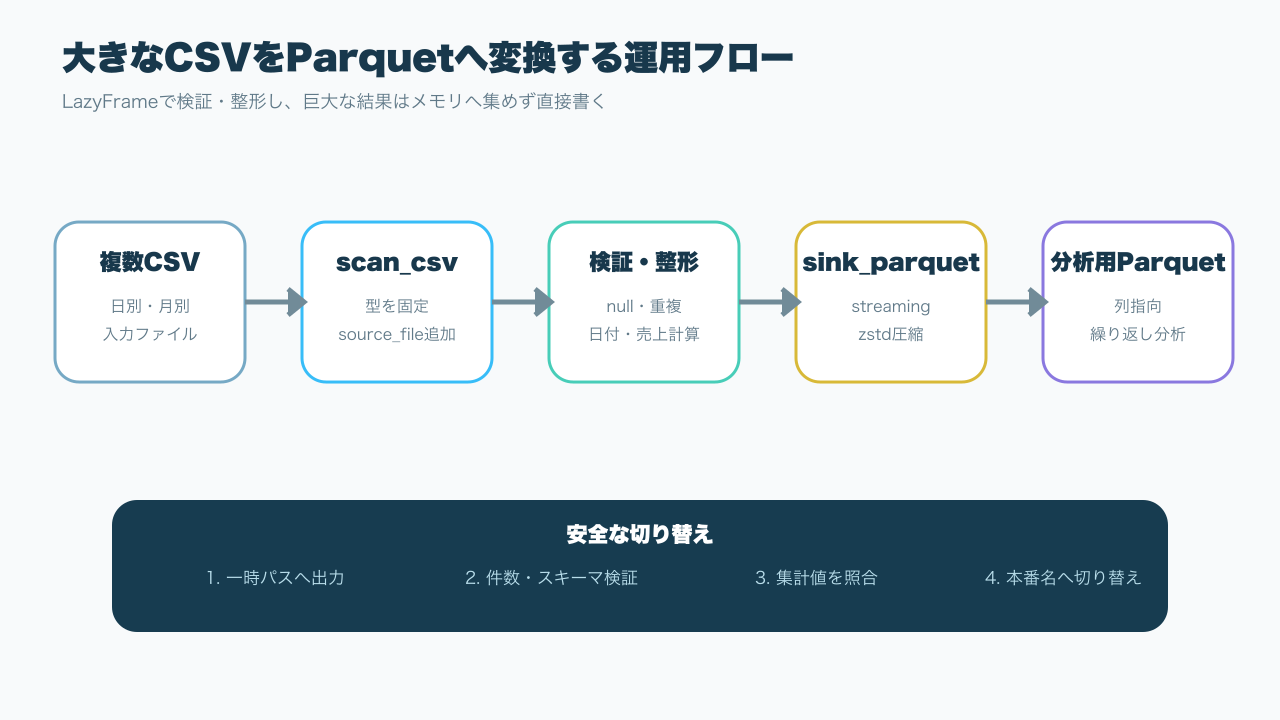
定期的に同じCSVを分析する場合は、取り込み時に型を整え、Parquetへ変換する構成が有効です。
from pathlib import Path

import polars as pl

def convert_orders_to_parquet(input_glob: str, output_path: Path) -> None:
    query = (
        pl.scan_csv(
            input_glob,
            schema_overrides={
                "customer_id": pl.String,
                "quantity": pl.Int64,
                "unit_price": pl.Int64,
                "status": pl.String,
            },
            try_parse_dates=True,
            include_file_paths="source_file",
        )
        .filter(pl.col("ordered_at").is_not_null())
        .with_columns(
            revenue=(pl.col("quantity") * pl.col("unit_price")),
            ingested_at=pl.lit("2026-08-16").str.to_date(),
        )
    )

    query.sink_parquet(
        output_path,
        compression="zstd",
        mkdir=True,
)変換後は、pl.scan_parquet()で必要列と必要期間だけを読みます。
sales = (
    pl.scan_parquet("warehouse/orders.parquet")
    .filter(pl.col("ordered_at") >= pl.date(2026, 1, 1))
    .select("ordered_at", "category", "revenue")
    .collect()
)
Parquetは列ごとに格納され、統計情報も持つため、列と行の絞り込みを読み込みへ反映しやすくなります。CSVは交換形式、Parquetは分析用形式と役割を分けると運用しやすくなります。
データ型でメモリ使用量を抑える
メモリ問題は行数だけでなく、列の型にも影響されます。すべてを文字列として保持すると、数値演算のたびに変換が必要です。逆に、欠損や範囲を考えず小さすぎる整数型を選ぶとエラーになります。
確認する項目は次の通りです。
- ID:数値計算しないならStringを検討
- 個数:値域が分かるなら適切な整数型
- 金額:小数誤差を避ける要件があれば整数の最小通貨単位やDecimalを検討
- 日付:StringのままにせずDateまたはDatetimeへ変換
- 低カーディナリティ文字列:Categoricalが有効か測定
- 欠損:nullと空文字を区別
df.estimated_size()でDataFrameの推定サイズを確認できます。LazyFrameでは実行前に最終サイズは分からないため、小さなサンプルや期間限定のクエリで型と件数を検証します。
Python UDFを避けてPolars式を使う
Python関数を各行へ適用するUDFは、Polarsのネイティブ式より遅くなり、最適化を妨げる場合があります。
たとえば、金額帯を付ける処理はmap_elements()よりwhen-then-otherwiseで書きます。
query = query.with_columns(
    revenue_band=(
        pl.when(pl.col("revenue") >= 100_000)
        .then(pl.lit("large"))
        .when(pl.col("revenue") >= 10_000)
        .then(pl.lit("medium"))
        .otherwise(pl.lit("small"))
    )
)
文字列、日付、リスト、構造体には多くのネイティブ式があります。まず公式APIで同等の式を探し、どうしても表現できない部分だけUDFにします。
パフォーマンス測定の方法
最適化前後を比較するときは、単に1回の実行時間だけを見ないようにします。
- 同じ入力ファイルと同じ出力条件を使う
- OSファイルキャッシュの影響を考慮する
- 複数回測定して中央値を見る
- 実行時間とピークメモリを両方確認する
- 出力件数・集計値が一致することを確認する
explain()で実行計画の差を確認する
CSV読み込みがボトルネックなら、CPU演算を改善しても効果は限定的です。繰り返し読むならParquet化、リモートストレージなら転送量削減、巨大な結果ならsinkの採用など、ボトルネックに合った対策を選びます。
よくある失敗
read_csv().lazy()を使う
DataFrameを全読み込みしてからLazyFrameへ変換しても、CSVスキャンへのpushdownはできません。最初からscan_csv()を使います。
途中でcollectを何度も呼ぶ
処理の途中ごとにcollect()すると、そのたびに実行され、クエリ全体の最適化が切れます。デバッグ時の小さな確認を除き、最後までLazyFrameをつなぎます。
全列を残したまま結合する
巨大テーブル同士の結合では、必要な列を確認し、フィルタ後に結合します。同名列、キー重複、多対多結合で行数が爆発していないか検証します。
maintain_orderを無条件で要求する
並び順が不要な集計でも順序維持を指定すると、最適化やストリーミングの自由度を下げる場合があります。順序が業務要件か、見た目の都合かを分けます。
streamingなら必ず速いと思う
streaming engineの主目的はメモリ圧力の低減であり、すべてのクエリで高速になる保証はありません。in-memoryとstreamingを同じ条件で測ります。
CSVの型推論を信用しすぎる
先頭サンプルにない値で型が変わることがあります。重要列はschema_overridesで指定し、入力監査を行います。
実運用前チェックリスト
- □
read_csv().lazy()ではなくscan_csv()から開始した - □ 必要な列と行だけをクエリで指定した
- □ 重要列の型を
schema_overridesで固定した - □ 日付、null、空文字、IDの先頭ゼロを確認した
- □
explain(optimized=True)で実行計画を確認した - □ 不要なPython UDFをPolars式へ置き換えた
- □ in-memoryとstreamingを同じ条件で測定した
- □ 巨大な結果は
collect()ではなくsink_*()を検討した - □ 出力件数、合計値、重複キーを検証した
- □ 一時ファイルから本番ファイルへ安全に切り替える設計にした
- □ Polarsのバージョンを固定し、更新時にAPI差分を確認した
- □ 実行時間、入力件数、出力件数、失敗理由をログへ残した
関連する可視化・CSV記事
集計結果をグラフへ出す場合は、PlotlyでグラフをHTML・画像保存する方法が参考になります。CSVをVS Codeで確認・編集したい場合は、VS CodeでCSVを見やすく編集する方法も利用できます。より大規模な可視化では、集計後の小さなDataFrameだけをPlotlyへ渡すと、ブラウザ側の負荷を抑えられます。
まとめ
Polars LazyFrameは、scan_csv()で入力を遅延読み込みし、処理全体を組み立てた後にcollect()またはsink_*()で実行します。クエリ全体を見られるため、必要列だけを読むprojection pushdown、条件を入力側へ寄せるpredicate pushdownなどを適用できます。
大きなCSVを扱うときは、まず不要列と不要行を減らし、型を固定し、explain()で実行計画を確認します。その上でcollect(engine="streaming")を試し、最終結果が巨大ならsink_parquet()で直接出力します。LazyFrame、ストリーミング、Parquetを役割ごとに組み合わせることで、処理時間だけでなくメモリ使用量と運用の安定性も改善できます。
コメント