生成AIを業務アプリへ組み込むとき、チャットの返答を受け取るだけなら数行で実装できます。しかし、実運用では「外部データを安全に参照したい」「返答を決まった形式で受け取りたい」「テストで挙動を固定したい」といった要求が増えます。プロンプトとAPI呼び出しを一つの関数へ詰め込むと、処理の境界が曖昧になり、変更や障害対応が難しくなります。
Pydantic AIは、Pydanticの型検証を活かしてAIエージェントを構築するPythonフレームワークです。Agentを中心に、指示、Function Tool、依存性、構造化出力を組み合わせられます。FastAPIに近い書き味で、LLMの不確実な出力とアプリケーションの決定的な処理を分離しやすいのが特徴です。
この記事では、問い合わせ内容を分類し、社内データをツールで参照し、型付きの回答を返す最小エージェントを題材にします。単なるコード例だけでなく、どこまでをLLMへ任せ、どこからをPython側で制御するか、テストや運用では何を確認するかまで順番に解説します。
Pydantic AIとは
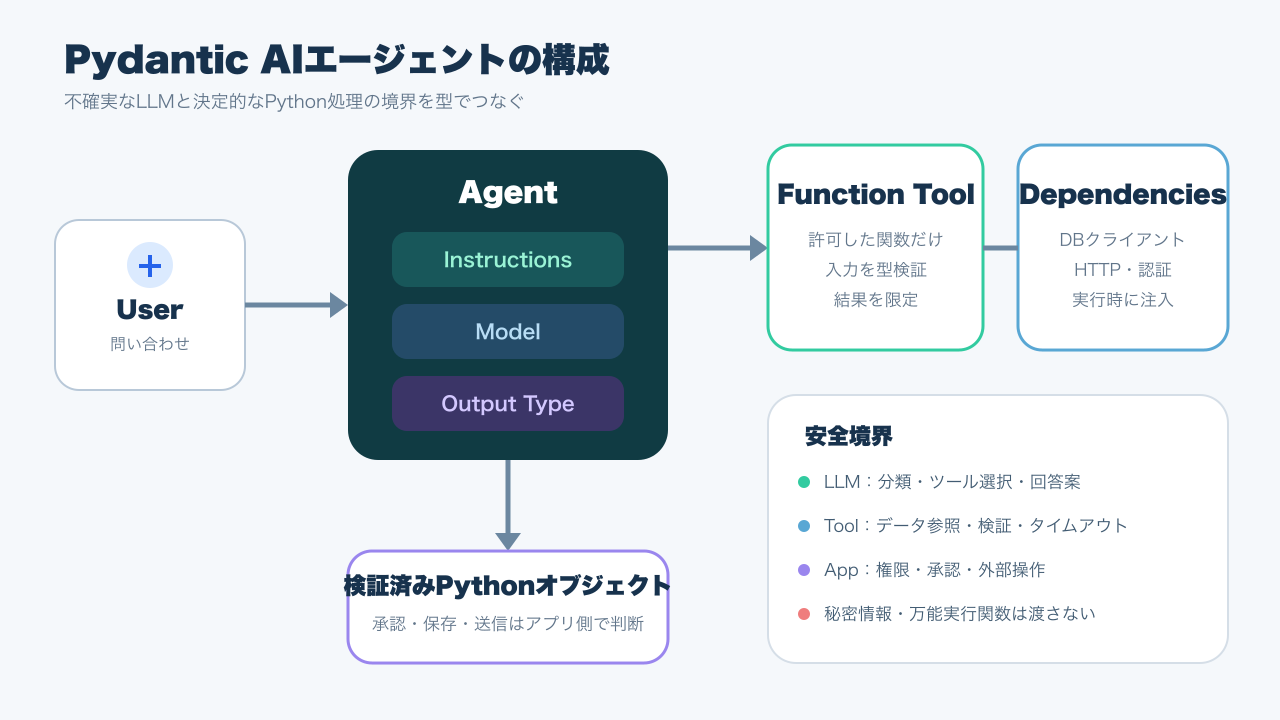
Pydantic AIは、LLMを利用するアプリケーションを型安全に組み立てるためのPythonフレームワークです。公式ドキュメントでは、Agentを「指示、ツール、構造化出力、依存性、モデル設定などを保持するコンテナ」として説明しています。
中心になる考え方は次の4つです。
| 要素 | 役割 | Python側で得られる利点 |
|---|---|---|
| Agent | 1つの目的を持つ実行単位 | 設定と実行をまとめて再利用できる |
| Instructions | LLMへ渡す役割・制約 | プロンプトの責務を明確にできる |
| Function Tool | LLMから呼び出せる関数 | DBやAPI処理を通常の関数として実装できる |
| Output Type | 最終回答の型 | Pydanticで検証済みの値を受け取れる |
| Dependencies | 実行時に注入する資源 | 認証情報やクライアントをグローバル変数から分離できる |
従来のAPI直接呼び出しでもFunction CallingやJSON Schemaは利用できます。Pydantic AIの価値は、それらをAgent、Python型、実行コンテキストとして一貫した形で扱えることです。特定のモデルだけに依存せず、アプリケーション側の境界を先に設計したい場合に向いています。
一方、単発の要約や翻訳だけならフレームワークを導入せず、モデルSDKを直接呼ぶ方が簡潔です。Pydantic AIは「ツールが増える」「構造化出力を下流処理へ渡す」「複数の実行経路をテストする」といった段階で効果が出ます。
インストールと最小構成
Python 3.10以上の仮想環境を用意し、Pydantic AIをインストールします。
python -m venv .venv
source .venv/bin/activate
pip install pydantic-ai
利用するモデルプロバイダーに応じてAPIキーを環境変数へ設定します。キーをソースコードへ直接書かないことが重要です。
export OPENAI_API_KEY="your-api-key"最小のエージェントは、Agentを生成してrun_sync()またはrun()を呼びます。
from pydantic_ai import Agent

agent = Agent(
    "openai:gpt-5.6-sol",
    instructions="質問へ日本語で簡潔に回答してください。",
)

result = agent.run_sync("Pythonのdataclassを一文で説明して")
print(result.output)同期処理ではrun_sync()、asyncioを使うWebアプリやワーカーではawait agent.run()を選びます。公式にはストリーミングやグラフ単位の反復実行も用意されていますが、最初は完了結果を返す2つの方法だけで十分です。
この記事では、2026年8月時点でPydantic AI公式ドキュメントがOpenAI連携の基本例に採用しているopenai:gpt-5.6-solを使います。openai:プレフィックスはResponses APIを利用します。GPT-5.2は現在も利用できますが、OpenAI公式では旧世代として扱われているため、新規実装の既定例にはしません。
モデル名は固定値として散在させず、環境変数や設定ファイルから渡せるようにします。モデル変更、リージョン変更、テスト用モデルへの差し替えが容易になります。実運用では品質優先ならgpt-5.6-sol、コストとのバランスならgpt-5.6-terraなど、利用可能なモデルを代表データで比較してください。
構造化出力をPydanticモデルで受け取る
自由文の返答を別の処理へ渡すと、表記揺れや欠損値の扱いが問題になります。たとえば問い合わせ分類で「重要度はhigh、medium、lowのいずれか」とプロンプトに書いても、モデルが「urgent」や日本語の「高」を返す可能性があります。
Pydanticモデルをoutput_typeへ指定すると、最終結果を検証済みのPythonオブジェクトとして受け取れます。
from typing import Literal

from pydantic import BaseModel, Field
from pydantic_ai import Agent

class SupportDecision(BaseModel):
    category: Literal["billing", "technical", "account", "other"]
    priority: Literal["high", "medium", "low"]
    summary: str = Field(min_length=1, max_length=200)
    needs_human: bool

triage_agent = Agent(
    "openai:gpt-5.6-sol",
    output_type=SupportDecision,
    instructions=(
        "問い合わせを分類してください。確信が低い場合や、返金・契約変更を含む場合は"
        "needs_humanをtrueにしてください。"
    ),
)

result = triage_agent.run_sync(
    "ログインできず、パスワード再設定メールも届きません。"
)

decision = result.output
print(decision.category)
print(decision.needs_human)この設計では、LLMは分類と要約を担当し、実際に返金する、アカウントを変更する、メールを送るといった操作は担当しません。後続処理はneeds_humanやpriorityを通常のPython分岐として評価できます。
構造化出力は「モデルが必ず正しい判断をする」仕組みではありません。保証されるのは主に形式です。値の意味が正しいか、外部操作を許可してよいかは、Python側のルールと人間の承認で補います。
Function Toolで外部データを参照する
LLMは学習時点以降の社内在庫や顧客状態を知りません。必要な情報をすべてプロンプトへ貼ると、トークン量、情報漏えい、鮮度の問題が生じます。そこで、許可した関数だけをFunction Toolとして登録します。
from pydantic_ai import Agent

product_agent = Agent(
    "openai:gpt-5.6-sol",
    instructions=(
        "商品について回答するときはget_productを使ってください。"
        "在庫数を推測してはいけません。"
    ),
)

@product_agent.tool_plain
def get_product(product_id: str) -> dict[str, object]:
    """商品IDから公開可能な商品情報だけを返す。"""
    catalog = {
        "A-100": {"name": "USB-C Hub", "stock": 12, "price_yen": 5980},
        "B-200": {"name": "Laptop Stand", "stock": 0, "price_yen": 4200},
    }
    return catalog.get(product_id, {"error": "not_found"})

result = product_agent.run_sync("A-100は在庫がありますか?")
print(result.output)tool_plainは実行コンテキストが不要な単純関数に向いています。関数名、型ヒント、docstringからツールのスキーマと説明が作られるため、曖昧な名前を避け、引数の意味を明確にします。
ツール設計では「モデルに何でもできる万能関数を渡さない」ことが重要です。run_sql(query: str)やrequest(url: str)のような関数は柔軟ですが、意図しないデータ参照やSSRF、破壊的クエリにつながります。get_product(product_id)のように対象と操作を限定すると、入力検証と監査が容易になります。
読み取りツールと書き込みツールも分離します。データ参照は自動化できても、購入、削除、公開、送信は人間承認を挟む設計が安全です。
DependenciesでAPIクライアントを注入する
実際のアプリでは、ツールがDB接続、HTTPクライアント、認証済みサービスを利用します。それらをグローバル変数へ置くと、テスト時の差し替えやリクエスト単位の認証が難しくなります。
Pydantic AIではdeps_typeとRunContextを使い、実行時の依存性をツールへ渡せます。
from dataclasses import dataclass
from typing import Protocol

from pydantic_ai import Agent, RunContext

class ProductRepository(Protocol):
    async def find(self, product_id: str) -> dict[str, object] | None: ...

@dataclass
class AppDeps:
    repository: ProductRepository
    tenant_id: str

agent = Agent(
    "openai:gpt-5.6-sol",
    deps_type=AppDeps,
    instructions="商品情報はfind_productで確認し、存在しない場合は推測しないでください。",
)

@agent.tool
async def find_product(
    ctx: RunContext[AppDeps], product_id: str
) -> dict[str, object]:
    item = await ctx.deps.repository.find(product_id)
    if item is None:
        return {"error": "not_found"}
return {"tenant_id": ctx.deps.tenant_id, "product": item}Agent自体はアプリ全体で再利用し、depsだけを実行ごとに渡せます。Webリクエストならログイン中のテナントID、バッチなら対象ジョブID、テストなら偽のRepositoryを注入できます。
依存性へAPIキーを含める場合でも、ツールの返り値へキーを混ぜないようにします。RunContextはPython側の実行コンテキストであり、依存性全体が自動的にモデルへ送られるわけではありません。ただし、ツールが返した値や例外メッセージはモデルやログへ渡り得るため、境界で除去します。
実用例:問い合わせトリアージエージェント
ここまでの要素を、問い合わせ分類へまとめます。エージェントはFAQを検索し、回答案と人間確認の要否を構造化出力します。外部送信は行いません。
from dataclasses import dataclass
from typing import Literal

from pydantic import BaseModel, Field
from pydantic_ai import Agent, RunContext

class DraftReply(BaseModel):
    category: Literal["billing", "technical", "account", "other"]
    confidence: float = Field(ge=0.0, le=1.0)
    reply: str = Field(min_length=1, max_length=800)
    cited_faq_ids: list[str]
    needs_human: bool

@dataclass
class SupportDeps:
    faq: dict[str, str]

support_agent = Agent(
    "openai:gpt-5.6-sol",
    deps_type=SupportDeps,
    output_type=DraftReply,
    instructions=(
        "問い合わせへの回答案を作成してください。FAQにない事実を作らず、"
        "返金、解約、個人情報、確信0.7未満ではneeds_humanをtrueにしてください。"
    ),
)

@support_agent.tool
def search_faq(ctx: RunContext[SupportDeps], keyword: str) -> list[dict[str, str]]:
    """キーワードを含むFAQを最大3件返す。"""
    keyword_lower = keyword.lower()
    hits = [
        {"id": faq_id, "content": content}
        for faq_id, content in ctx.deps.faq.items()
        if keyword_lower in content.lower()
    ]
    return hits[:3]

faq = {
    "FAQ-LOGIN-01": "パスワード再設定メールは通常5分以内に届きます。",
    "FAQ-LOGIN-02": "迷惑メールフォルダと登録メールアドレスを確認してください。",
}

result = support_agent.run_sync(
    "パスワード再設定メールが届きません。",
    deps=SupportDeps(faq=faq),
)

draft = result.output
if draft.needs_human:
    print("確認待ち:", draft.reply)
else:
print("自動送信せず、承認候補として保存:", draft.reply)この例では、エージェントが生成するのは回答「案」です。needs_human=Falseでも、そのまま送信せず承認候補として保存しています。運用で十分な評価データが集まり、低リスクな問い合わせだけ自動送信したい場合に、後から範囲を狭く有効化できます。
実行フローと責任分界
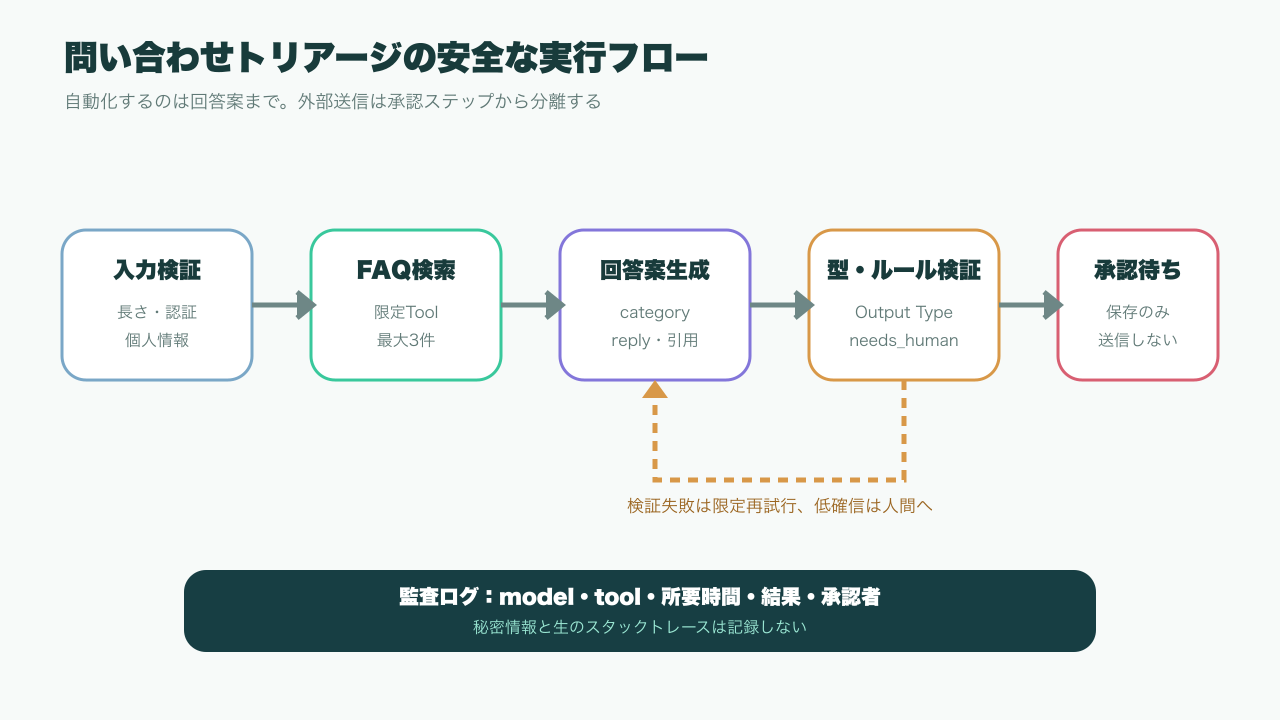
AIエージェントを安全に運用するには、処理を次の3層に分けます。
- LLM層:意図理解、必要なツールの選択、回答案生成
- ツール層:許可されたデータ参照、入力検証、タイムアウト
- アプリ層:承認、保存、外部送信、監査ログ
LLM層には曖昧さの処理を任せ、金額上限、ユーザー権限、公開可否のようなルールはアプリ層で判定します。プロンプトで「絶対に送信しない」と書くことは補助になりますが、送信関数自体を渡さない方が強い制約です。
ツールは成功結果だけでなく、not_found、timeout、permission_deniedのような予測可能な失敗を構造化して返します。生のスタックトレースや接続文字列をモデルへ返さないようにします。
エラー処理・再試行・利用上限
LLMアプリには、モデルAPI、ツール、下流APIという複数の障害点があります。すべてを同じ回数だけ再試行すると、重複実行や待ち時間増大につながります。
設計時は次を分けて考えます。
| 障害 | 代表例 | 推奨対応 |
|---|---|---|
| モデル一時障害 | 429、5xx | SDKまたはモデル層で限定再試行 |
| 出力検証失敗 | 型不一致、必須値欠損 | 出力再試行または人間確認 |
| ツール入力不正 | 未知ID、範囲外 | 再試行せず明示エラー |
| 外部APIタイムアウト | FAQ検索の遅延 | 短いタイムアウトと限定再試行 |
| 書き込み結果不明 | 送信後に応答切断 | 冪等性キーで照合してから再試行 |
また、1回の実行で許すリクエスト数やトークン量を無制限にしないことも重要です。Pydantic AIには利用上限を設定する仕組みがあります。アプリ側でもタイムアウト、同時実行数、ジョブ単位の予算を設定し、異常なループを止めます。
テストではモデルを呼ばず境界を確認する
AIエージェントのテストをすべて実モデルで行うと、費用、速度、再現性が問題になります。テスト対象を分けます。
- ツール関数:通常のPython単体テストとして入力と返り値を確認
- 出力モデル:境界値、欠損、禁止値をPydanticで確認
- エージェント経路:テスト用モデルや固定応答でツール呼び出しを確認
- 品質評価:代表データセットだけ実モデルで定期評価
ツール関数はLLMから独立しているため、最初にここを厚くテストできます。
def test_search_faq_limits_results() -> None:
    faq = {f"FAQ-{i}": f"login guide {i}" for i in range(10)}
    deps = SupportDeps(faq=faq)
    # 実際のプロジェクトではRunContextを介する部分と検索ロジックを分離してテストする
    hits = [
        {"id": faq_id, "content": content}
        for faq_id, content in deps.faq.items()
        if "login" in content.lower()
    ][:3]
    assert len(hits) == 3
プロンプト変更時は、正常例だけでなく、FAQにない質問、個人情報を含む質問、返金要求、ツールタイムアウトを含めます。正解文の完全一致より、category、needs_human、引用FAQ IDなど、業務上重要な条件を評価します。
FastAPIへ組み込むときの考え方
FastAPIではAgentをモジュールレベルで再利用し、リクエストごとの依存性をdepsへ渡します。エンドポイントで長い処理を同期実行せず、await agent.run()を利用します。
from fastapi import FastAPI
from pydantic import BaseModel

app = FastAPI()

class SupportRequest(BaseModel):
    message: str = Field(min_length=1, max_length=4000)

@app.post("/support/draft", response_model=DraftReply)
async def create_support_draft(request: SupportRequest) -> DraftReply:
    deps = SupportDeps(faq=faq)
    result = await support_agent.run(request.message, deps=deps)
return result.output本番では認証、レート制限、タイムアウト、監査ログを追加します。replyをレスポンスとして返すだけなら外部送信ではありませんが、メールAPIやチケット更新APIを呼ぶ場合は別の承認ステップにします。
よくある失敗
1つの巨大なツールを渡す
SQL、HTTP、ファイル操作を自由に実行できるツールは便利に見えますが、検証範囲が広がります。業務操作単位の小さなツールへ分割し、引数を型と許可リストで制限します。
プロンプトだけで権限を制御する
「削除しないでください」という指示より、削除ツールを登録しない方が確実です。権限はPython側でチェックし、必要なら人間承認後に別プロセスで実行します。
依存性とツール結果を混同する
Depsに入れた情報はそのままモデルへ渡るわけではありません。しかし、ツールが返した値はモデルへ渡ります。返却フィールドを明示し、秘密情報を除外します。
型があれば意味も正しいと思う
confidence=0.95が型検証を通っても、その確信度が校正済みとは限りません。高リスクな判断は、確信度だけで自動化せず、ルールと評価データを組み合わせます。
毎回Agentを作り直す
Agentは再利用を前提に設計できます。固定設定は一度生成し、リクエスト固有値だけをdepsやrun引数へ渡します。
実運用前チェックリスト
- □ Agentの目的を1つに絞った
- □ モデル名とAPIキーを設定から注入した
- □ 最終出力をPydanticモデルで検証した
- □ ツールを許可リストとして必要最小限にした
- □ ツール引数をPython側でも検証した
- □ DB・HTTPクライアントをDependenciesで注入した
- □ 外部送信、購入、削除、公開を別の承認処理にした
- □ タイムアウト、最大実行回数、利用上限を設定した
- □ ツール結果と例外から秘密情報を除いた
- □ 正常系、未知ID、API障害、低確信ケースをテストした
- □ モデル名、所要時間、ツール名、成功・失敗を記録した
- □ 実モデル評価の代表データセットを用意した
Pydantic AIと他の方法の使い分け
Pydantic AIは、Python型とツール境界を重視するアプリに向いています。複雑な分岐をすべてエージェントへ委ねる必要はありません。決定的なワークフローは通常のPythonで書き、その一部にAgentを配置する方が保守しやすい場合があります。
OpenAI APIのFunction Callingを直接使いたい場合は、Function Calling入門が参考になります。ツール連携の標準化を検討している場合は、MCPとFunction Callingの違いも確認してください。AIエージェント全体の最小構成は、Pythonで動かすAIエージェントで解説しています。
まとめ
Pydantic AIでは、Agentへ指示、Function Tool、Dependencies、Output Typeを組み合わせ、LLMアプリの境界をPython型として表現できます。特に、構造化出力を後続処理へ渡す、実行時のDBやAPIクライアントを注入する、ツールを通常のPython関数としてテストするといった場面で効果があります。
重要なのは、AIエージェントへすべてを任せることではありません。曖昧な判断と文章生成はLLM、データ参照は限定ツール、権限・承認・外部操作はアプリケーションという分担を作ることです。この境界が明確なら、最小構成から始めて、評価結果を見ながら安全に自動化範囲を広げられます。
コメント