FastMCPでMCPサーバーを作ると、ローカルでは問題なく動いていたツールが、本番公開後に急に不安定になることがあります。呼び出しが集中して外部APIの上限へ達する、遅い処理がワーカーを占有する、タイムアウトした処理を再試行して負荷をさらに増やす、といった連鎖が典型例です。
この問題は、単に「タイムアウトを5秒にする」「1秒10回に制限する」だけでは解決しません。クライアント、FastMCPツール、外部APIという複数の層に時間制限があり、レート制限・再試行・冪等性も組み合わせて設計する必要があります。
この記事ではFastMCP 3系の公式機能を使い、レート制限、ツールタイムアウト、クライアントタイムアウト、外部HTTP通信のタイムアウト、再試行を一つの運用設計としてまとめます。
この記事の結論
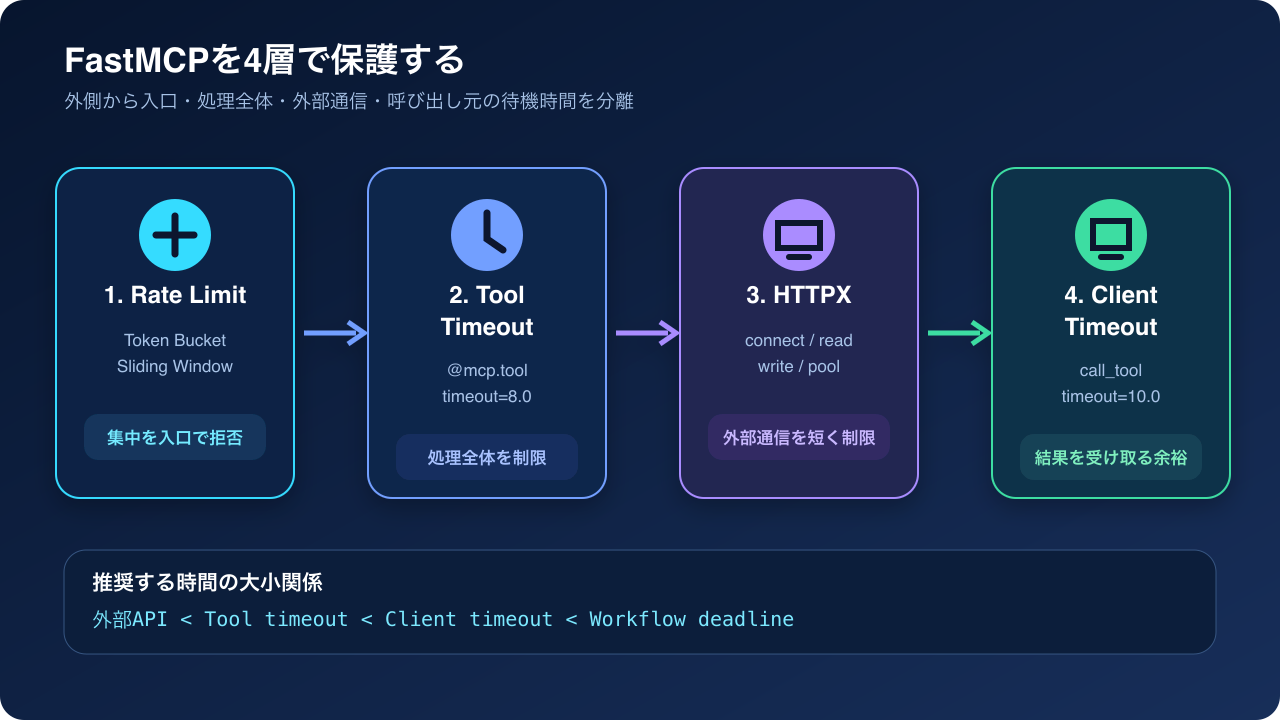
「入口のレート制限」「処理全体のツールタイムアウト」「外部通信の短いタイムアウト」「限定的な再試行」の4層で守ります。再試行は接続エラーなど一時的な失敗だけに限定し、書き込み系ツールでは冪等性を確認できない限り自動再試行しません。
- FastMCPのレート制限とタイムアウトは何を守るのか
- 今回の前提:FastMCP 3系を使う
- まずツール全体にタイムアウトを設定する
- クライアントの待ち時間はサーバーより少し長くする
- 外部APIはconnect・read・write・poolを分ける
- Token Bucketで短い集中アクセスを吸収する
- Sliding Windowを選ぶ場面
- クライアント識別を設計する
- Retry Middlewareは対象例外を狭くする
- ミドルウェアの順序を決める
- タイムアウト後に処理が止まったと決めつけない
- バックグラウンドタスクは別のタイムアウトを使う
- 監視では「どこで止まったか」を記録する
- テストで確認するシナリオ
- よくある失敗と直し方
- 本番導入前のチェックリスト
- まとめ
- 公式リファレンス
FastMCPのレート制限とタイムアウトは何を守るのか
最初に、それぞれの役割を分けて考えます。
| 制御 | 守る対象 | 主な設定場所 | 代表的な失敗 |
|---|---|---|---|
| レート制限 | サーバー、外部API、費用 | FastMCP Middleware | 短時間の集中アクセス |
| ツールタイムアウト | FastMCPの実行枠 | @mcp.tool(timeout=...) |
ハング、想定外の長時間処理 |
| クライアントタイムアウト | 呼び出し元の待ち時間 | client.call_tool(timeout=...) |
UIやエージェントが待ち続ける |
| 外部通信タイムアウト | HTTP接続と接続プール | HTTPXなど | 接続・読取・書込・pool待ち |
| 再試行 | 一時的な通信障害 | Retry Middlewareなど | 瞬断、接続失敗 |
レート制限は「一定時間に何件まで受け付けるか」を決めます。タイムアウトは「1件を何秒まで処理するか」を決めます。両方が必要です。たとえば1秒10件に制限しても、各処理が60秒止まれば最大600件分の処理が滞留しかねません。一方、処理を5秒で打ち切っても、1秒1,000件が届けば入口で過負荷になります。
再試行は保護機能ではなく、失敗をもう一度実行する仕組みです。設定を誤ると、障害中のシステムへ追加負荷を送り込む「リトライストーム」を起こします。タイムアウトとレート制限を先に設計し、その内側で最小限だけ使うのが基本です。
今回の前提:FastMCP 3系を使う
FastMCP公式ドキュメントでは、ツールのtimeoutはバージョン3.0.0で追加された機能として説明されています。この記事のコードはFastMCP 3系を前提にしています。
環境を再現できるように、実際のプロジェクトでは依存バージョンを固定してください。
fastmcp>=3,<4
httpx>=0.27,<1
上記は記事の説明用の範囲例です。本番では検証済みの具体的なバージョンへ固定し、更新時にテストを通します。
まずツール全体にタイムアウトを設定する
FastMCP 3系では、ツールごとにtimeoutを秒単位で指定できます。
import asyncio

from fastmcp import FastMCP

mcp = FastMCP("Protected MCP Server")

@mcp.tool(timeout=8.0)
async def summarize_document(document_id: str) -> dict[str, str]:
    """文書を読み取り、要約を返す。"""
    await asyncio.sleep(0.1)
return {"document_id": document_id, "summary": "要約結果"}公式ドキュメントによると、指定時間を超えた場合はクライアントへMCPエラーコード-32000が返ります。同期・非同期ツールの両方が対象ですが、サーバー全体へ適用する既定タイムアウトはありません。つまり、保護したいツールが自分で明示的にtimeoutを指定する必要があります。
タイムアウト値を決めるときは、正常時の平均ではなくp95やp99を見るのが重要です。正常時p95が2秒なら、最初は5〜8秒など余裕のある値から始め、監視結果を見ながら狭めます。正常処理が頻繁に打ち切られる値は短すぎますが、利用者が離脱するほど長い値にも意味がありません。
目安は次の順で決めます。
- 利用者や上位エージェントが待てる最大時間を決める
- 外部APIの通常時p95を測る
- DB・整形・シリアライズの時間を加える
- 小さな余裕を追加する
- ステージングで遅延を注入して確認する
クライアントの待ち時間はサーバーより少し長くする
FastMCP Clientのcall_tool()にもtimeoutがあります。呼び出しごとの値は、クライアント全体に設定された値を上書きします。
from fastmcp import Client

async def call_server() -> None:
    async with Client("http://127.0.0.1:8000/mcp") as client:
        result = await client.call_tool(
            "summarize_document",
            {"document_id": "doc-123"},
            timeout=10.0,
        )
        print(result.data)
サーバーのツールタイムアウトが8秒なら、クライアントは通信の往復とエラー返却を受け取れるよう10秒程度にします。逆にクライアントを5秒にすると、サーバーが8秒まで処理を続けられるのに、呼び出し元は先に諦めます。キャンセルが下流処理まで確実に伝播しない構成では、利用者が結果を受け取れないままサーバー側の処理だけが続くこともあります。
推奨する大小関係は次の通りです。
外部APIのread timeout
  < FastMCPツールtimeout
  < FastMCP Client timeout
  < 上位ワークフロー全体のdeadline
すべてを同じ5秒にすると、どの層が最初に失敗するかがネットワークの揺らぎで変わり、原因分析が難しくなります。各層に少し差をつけてください。
外部APIはconnect・read・write・poolを分ける
ツールの中から外部APIを呼ぶ場合、ツール全体のタイムアウトだけに頼るのは不十分です。HTTPXにはconnect、read、write、poolの4種類のタイムアウトがあります。
import httpx
from fastmcp import FastMCP

mcp = FastMCP("Protected MCP Server")

HTTP_TIMEOUT = httpx.Timeout(
    timeout=4.0,
    connect=1.5,
    read=4.0,
    write=2.0,
    pool=1.0,
)
HTTP_LIMITS = httpx.Limits(
    max_connections=20,
    max_keepalive_connections=10,
)

@mcp.tool(timeout=7.0)
async def fetch_weather(city: str) -> dict:
    async with httpx.AsyncClient(
        timeout=HTTP_TIMEOUT,
        limits=HTTP_LIMITS,
    ) as client:
        response = await client.get(
            "https://api.example.com/weather",
            params={"city": city},
        )
        response.raise_for_status()
        return response.json()
各値の意味は次の通りです。
connect: 接続確立を待つ時間read: レスポンスのデータを受け取る待ち時間write: リクエストデータを書き出す待ち時間pool: 接続プールから空き接続を得る待ち時間
HTTPXはネットワーク非活動が5秒続くとタイムアウトする既定動作を持ちますが、運用では明示した方が意図が伝わります。特にpoolタイムアウトは見落とされがちです。外部APIが遅くなると接続が返却されず、後続リクエストが接続プール待ちで失敗します。これは外部APIのread timeoutとは別の問題です。
なお、例では説明を簡潔にするためリクエストごとにAsyncClientを作っています。高頻度な本番処理では、アプリケーションのライフサイクルに合わせてクライアントを安全に再利用し、接続プールを活用します。
Token Bucketで短い集中アクセスを吸収する
FastMCPにはレート制限用Middlewareがあります。RateLimitingMiddlewareはToken Bucket方式で、一定の処理率を維持しながら、burst_capacityの範囲で短い集中を許容します。
from fastmcp import FastMCP
from fastmcp.server.middleware.rate_limiting import RateLimitingMiddleware

mcp = FastMCP("Rate Limited Server")
mcp.add_middleware(
    RateLimitingMiddleware(
        max_requests_per_second=10.0,
        burst_capacity=20,
    )
)
この例は継続的には毎秒10件、短時間には最大20件のバーストを許す設計です。値を決めるときはFastMCPサーバーのCPUだけでなく、データベース、外部API、課金上限も確認します。
たとえば外部APIが1分600件までなら、理論上は毎秒10件です。しかし別のバッチ処理も同じAPIキーを使う場合、FastMCPへ毎秒10件をすべて割り当てることはできません。安全余裕と他の利用者分を差し引き、毎秒6〜8件から始める方が安全です。
burst_capacityを大きくしすぎると、平均レートは守っていても外部APIへ瞬間的な集中が届きます。重いツールでは、許容同時実行数と同程度か、それより小さい値から検証します。
Sliding Windowを選ぶ場面
SlidingWindowRateLimitingMiddlewareは、指定した時間窓の中の最大件数を制御します。
from fastmcp.server.middleware.rate_limiting import (
    SlidingWindowRateLimitingMiddleware,
)

mcp.add_middleware(
    SlidingWindowRateLimitingMiddleware(
        max_requests=100,
        window_minutes=1,
    )
)
選び方は次のように整理できます。
| 方式 | 向いている用途 | 注意点 |
|---|---|---|
| Token Bucket | 短いバーストを許しつつ平均速度を守る | burstを大きくしすぎない |
| Sliding Window | 「直近1分で100件」のような契約上限へ合わせる | 時間窓の境界付近も含めて試験する |
外部APIの契約が「毎分100回」のように定義されているならSliding Windowが理解しやすく、チャットUIのように短い集中を許したいならToken Bucketが扱いやすいでしょう。
クライアント識別を設計する
FastMCPのレート制限Middlewareは、クライアント識別用の関数を設定できます。共有サーバーでは、全利用者を一つのバケットへ入れるのか、利用者・APIキー・テナントごとに分けるのかを先に決めます。
全体制限だけでは、1人の大量利用によって他の利用者も拒否されます。一方、利用者ごとの制限だけでは、多数の利用者が同時に来たときサーバー全体を守れません。実運用では次の2段構成が堅実です。
- API Gatewayやリバースプロキシでサーバー全体の上限を設定
- FastMCP側で認証済み利用者またはテナント単位の上限を設定
ここでIPアドレスだけを識別子にすると、NAT配下の複数利用者が同一人物に見えたり、プロキシ経由の情報を誤って信頼したりします。認証済みsubjectや内部テナントIDなど、サーバーが検証できる値を使ってください。具体的な取り出し方は認証構成によって変わるため、公式APIと自分の認証Middlewareを確認して実装します。
Retry Middlewareは対象例外を狭くする
FastMCPのRetryMiddlewareは、一時的な失敗を指数バックオフで再試行できます。公式例ではConnectionErrorとTimeoutErrorを対象にしています。
from fastmcp.server.middleware.error_handling import RetryMiddleware

mcp.add_middleware(
    RetryMiddleware(
        max_retries=2,
        retry_exceptions=(ConnectionError, TimeoutError),
    )
)
最初は再試行回数を1〜2回に抑えます。3回再試行する設定は「初回+3回」で最大4回実行され得ます。障害時の負荷と待ち時間を必ず計算してください。
自動再試行に向くのは、接続確立の一時的な失敗や、短時間で回復すると分かっている通信障害です。次の失敗は原則として自動再試行しません。
- 認証・認可エラー
- 引数検証エラー
- 存在しないID
- 利用上限を超えたことが明確なエラー
- 購入、送信、登録、削除など冪等性を保証できない処理
- 恒久的な設定ミス
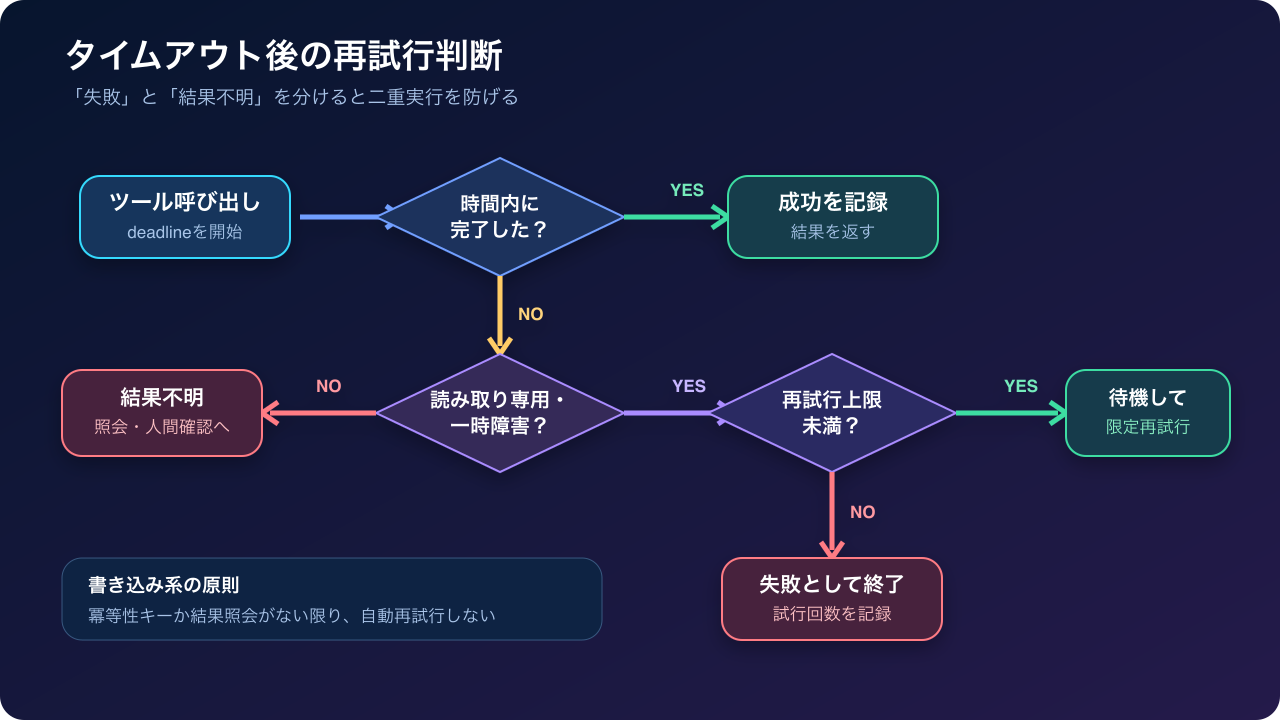
特に書き込みツールは注意が必要です。外部サービスでは処理が完了したものの、応答だけ届かなかった場合、同じ要求を再試行すると二重送信や二重購入になります。外部APIが冪等性キーをサポートしている場合は、一つの論理操作で同じキーを再利用します。サポートがない場合は、自動再試行を無効にするか、実行結果を照会してから判断します。
ミドルウェアの順序を決める
FastMCPのMiddlewareは、追加した順にリクエストを包み、レスポンスは逆順に戻ります。公式ドキュメントも順序が重要だと説明しています。
from fastmcp import FastMCP
from fastmcp.server.middleware.error_handling import (
    ErrorHandlingMiddleware,
    RetryMiddleware,
)
from fastmcp.server.middleware.logging import LoggingMiddleware
from fastmcp.server.middleware.rate_limiting import RateLimitingMiddleware
from fastmcp.server.middleware.timing import TimingMiddleware

mcp = FastMCP("Production Server")

mcp.add_middleware(ErrorHandlingMiddleware())
mcp.add_middleware(
    RateLimitingMiddleware(
        max_requests_per_second=10.0,
        burst_capacity=20,
    )
)
mcp.add_middleware(
    RetryMiddleware(
        max_retries=2,
        retry_exceptions=(ConnectionError, TimeoutError),
    )
)
mcp.add_middleware(TimingMiddleware())
mcp.add_middleware(LoggingMiddleware())
このコードは構成例です。再試行Middlewareがどの例外を捕捉し、レート制限が各再試行をどう数えるかは、利用するFastMCPバージョンで統合テストしてください。Middlewareの順序を変えると、ログに残る時間や例外変換の範囲も変わります。
重要なのは、順序をコピペで決めないことです。次の観点で期待動作をテストします。
- 拒否された要求もアクセスログに残るか
- 再試行の各試行と論理リクエストを区別できるか
- 最終例外が機密情報を含まずクライアントへ返るか
- レート制限された要求を再試行しないか
- タイムアウト時の所要時間が期待値以内か
タイムアウト後に処理が止まったと決めつけない
タイムアウトは呼び出し元の待機を終わらせますが、外部システムで開始済みの処理まで必ず取り消せるとは限りません。たとえばメールAPIへ送信要求を出した直後にread timeoutが発生した場合、メールは送られている可能性があります。
そのため、変更を伴うツールでは次を組み合わせます。
- 論理操作ごとの冪等性キー
- 実行前後の状態記録
- タイムアウト後の結果照会
- 人間の承認境界
- 重複を検出できる一意制約
「タイムアウト=失敗」ではなく、「結果が不明な状態」を別に持つ設計が安全です。成功・失敗の二択だけで管理すると、不明状態を再実行して二重処理を起こします。
バックグラウンドタスクは別のタイムアウトを使う
FastMCP公式ドキュメントでは、@mcp.tool(timeout=...)はフォアグラウンド実行に適用され、task=Trueのバックグラウンドタスクには適用されないと説明されています。バックグラウンド実行はDocket workerで処理されるため、DocketのTimeout依存関係を使います。
from datetime import timedelta

from docket import Timeout
from fastmcp import FastMCP

mcp = FastMCP("Background Task Server")

@mcp.tool(task=True)
async def build_large_report(
    report_id: str,
    timeout: Timeout = Timeout(timedelta(minutes=10)),
) -> str:
    return f"queued:{report_id}"
数分かかることが正常な処理を、無理にフォアグラウンドで待たせる必要はありません。短い対話的処理は通常ツール、長時間処理はバックグラウンドタスクに分け、進捗確認やキャンセル方法も設計します。
監視では「どこで止まったか」を記録する
タイムアウト件数だけでは、原因を切り分けられません。最低限、次の情報を構造化ログやメトリクスへ残します。
- ツール名
- 論理リクエストIDと試行番号
- クライアントまたはテナントの匿名化識別子
- キュー待ち時間
- ツール実行時間
- 外部APIのconnect・read・pool時間
- 最終結果: success、rate_limited、timeout、tool_error、unknown
- 再試行回数
- 外部サービス名
トークン、Authorization header、ツール引数の個人情報、外部APIの生レスポンスはログへ残しません。必要な場合は許可リスト方式で安全な項目だけ記録します。
レート制限は拒否件数だけでなく、残容量が少ない時間帯、利用者ごとの偏り、外部APIの上限との差も見ます。タイムアウト率が上がる前にp95やpool待ち時間が悪化していることが多いため、先行指標として監視します。
テストで確認するシナリオ
設定後は正常系だけでなく、意図的に遅くしたサーバーと外部APIで確認します。
| テスト | 期待結果 |
|---|---|
| 正常処理 | 制限時間内に1回で成功する |
| ツールが規定時間を超える | クライアントへタイムアウトエラーが返る |
| 外部APIの接続が遅い | connect timeoutとして分類される |
| 外部APIの応答が途中で止まる | read timeoutとして分類される |
| 接続プールが枯渇する | pool timeoutとして分類される |
| バースト上限を超える | 余分な要求が実行前に拒否される |
| 一時的接続エラー | 上限回数まで再試行し、試行番号がログに残る |
| 認証エラー | 再試行せず即時終了する |
| 書き込み応答が欠落する | 自動再試行せずunknownとして照会へ回す |
負荷テストでは、前回の記事で扱った同時接続・p95・エラー率も合わせて確認します。レート制限値を上げるほどスループットが伸びるとは限りません。外部APIや接続プールの限界を超えると、p95とエラー率が急増します。
よくある失敗と直し方
すべてのタイムアウトを同じ秒数にする
どの層が最初に失敗するか不安定になります。外部通信、ツール全体、クライアント、上位ワークフローの順に少しずつ長くしてください。
タイムアウトを無効にする
HTTPXではtimeout=Noneで無効化できますが、本番の外部通信で無期限待機を許すと、障害時に接続やワーカーを使い切ります。長時間処理はバックグラウンド化し、無期限待機で解決しないようにします。
例外をすべて再試行する
入力ミスや認証エラーは待っても直りません。再試行対象を一時的な接続・タイムアウト系に絞り、回数を小さくします。
レート制限値を外部API上限と同じにする
他の処理、時刻境界、ネットワークの再送、契約上限の集計方法を考慮できません。安全余裕を残し、実測で調整します。
1プロセスで通った設定をそのまま水平分割する
複数プロセス・複数コンテナでは、レート制限の状態共有方法を必ず確認します。各インスタンスが独立に毎秒10件を許せば、3台で合計毎秒30件になる可能性があります。FastMCP Middlewareだけで全体上限を保証できると仮定せず、共有ストアまたはAPI Gateway側の制限を検討してください。これは配備構成に依存するため、採用バージョンの実装と負荷テストで確認します。
本番導入前のチェックリスト
- □ FastMCP 3系の検証済みバージョンを固定した
- □ 読み取り系と書き込み系でタイムアウト方針を分けた
- □ 外部API、ツール、クライアント、全体deadlineの順序を決めた
- □ connect・read・write・pool timeoutを明示した
- □ Token BucketまたはSliding Windowの選定理由を記録した
- □ バースト上限を外部APIと接続プールの容量以下で試験した
- □ 利用者単位とサーバー全体の制限を分けた
- □ 再試行対象を一時的な例外だけに限定した
- □ 書き込み系の冪等性キーまたは結果照会を用意した
- □ タイムアウト後のunknown状態を表現できる
- □ バックグラウンドタスクにはDocket側のTimeoutを設定した
- □ レート制限、各種タイムアウト、再試行を障害注入でテストした
- □ ログから認証情報と個人情報を除外した
- □ p95、エラー率、拒否件数、pool待ち時間を監視した
まとめ
FastMCPの安定運用では、一つの設定だけで全体を守ることはできません。入口ではレート制限で集中アクセスを抑え、ツールには処理全体の上限を設定し、外部HTTP通信はconnect・read・write・poolへ分けます。クライアント側の待ち時間はサーバーより少し長くし、利用者へ確実に結果またはエラーを返します。
再試行は一時的な失敗に限り、書き込み処理では冪等性と結果照会を優先します。タイムアウト後を単純な失敗にせずunknownとして扱うことが、二重送信や二重購入を防ぐ重要なポイントです。
次に実装を固めるときは、PythonでFastMCPサーバーを作る手順を土台にし、FastMCPをpytestでテストする方法で障害系を自動化してください。本番の可視化はFastMCPをOpenTelemetryで監視する方法、性能上限の確認はFastMCPの負荷テストへつなげられます。
コメント