Responses APIで推論時間の長い処理を実行すると、通常の同期リクエストでは、ブラウザ、CLI、Webサーバーが応答完了まで接続を保持する必要があります。ネットワーク切断、プロキシのタイムアウト、再実行による二重処理が起きると、モデル側では処理が続いているのに、アプリ側では結果を受け取れない状態になりがちです。
OpenAI Responses APIのBackground modeは、この問題を解決するための非同期実行機能です。リクエスト時にbackground=trueを指定すると、APIは処理をバックグラウンドで続行し、アプリはresponse IDを使って状態と結果を後から取得できます。
この記事では、Pythonでの開始、ポーリング、Webhook、キャンセル、再試行、保存期間、Zero Data Retentionとの関係まで、運用で迷いやすい点をまとめます。
結論:Background modeではresponse.idをジョブの主キーとして永続化し、最初は上限付きポーリング、継続運用では署名検証済みWebhookを使います。POSTのタイムアウトだけで同じ処理を再送せず、既存responseの確認を優先することが重要です。
Background modeとは
Background modeは、Responses APIの処理を同期HTTP接続から切り離す仕組みです。通常のResponses APIでは、create呼び出しが完了結果を返すまで待ちます。Background modeでは、作成直後のResponseがqueuedまたはin_progressの状態で返り、アプリはそのIDを保存します。
その後は、Responsesのretrieveで状態を確認するか、response.completedなどのWebhookイベントを受信して完了を知ります。モデルや入力形式を変える機能ではなく、処理結果の受け取り方を非同期化する機能です。
向いているのは、長い推論、複数ツールを使う処理、大きな入力、待ち時間が一定しない処理です。短いチャット応答や、生成途中をそのまま画面へ表示したい場合は、通常の同期処理やストリーミングの方が単純です。
ストリーミング、Batch APIとの違い
Background mode、ストリーミング、Batch APIは目的が異なります。
| 機能 | 主な目的 | 結果の受け取り | 向く処理 |
|---|---|---|---|
| 通常のResponses | 単純な同期呼び出し | 完了時に応答 | 短い処理 |
| Streaming | 途中出力を即時表示 | SSEイベント | 対話UI |
| Background mode | 長時間処理を非同期化 | retrieveまたはWebhook | 単発の長い処理 |
| Batch API | 大量リクエストをまとめて処理 | バッチ完了後 | オフライン大量処理 |
Background modeは「1件の処理を切断に強くする」用途です。多数の独立リクエストを安価にまとめて処理したい場合は、Batch APIを検討します。
全体フロー
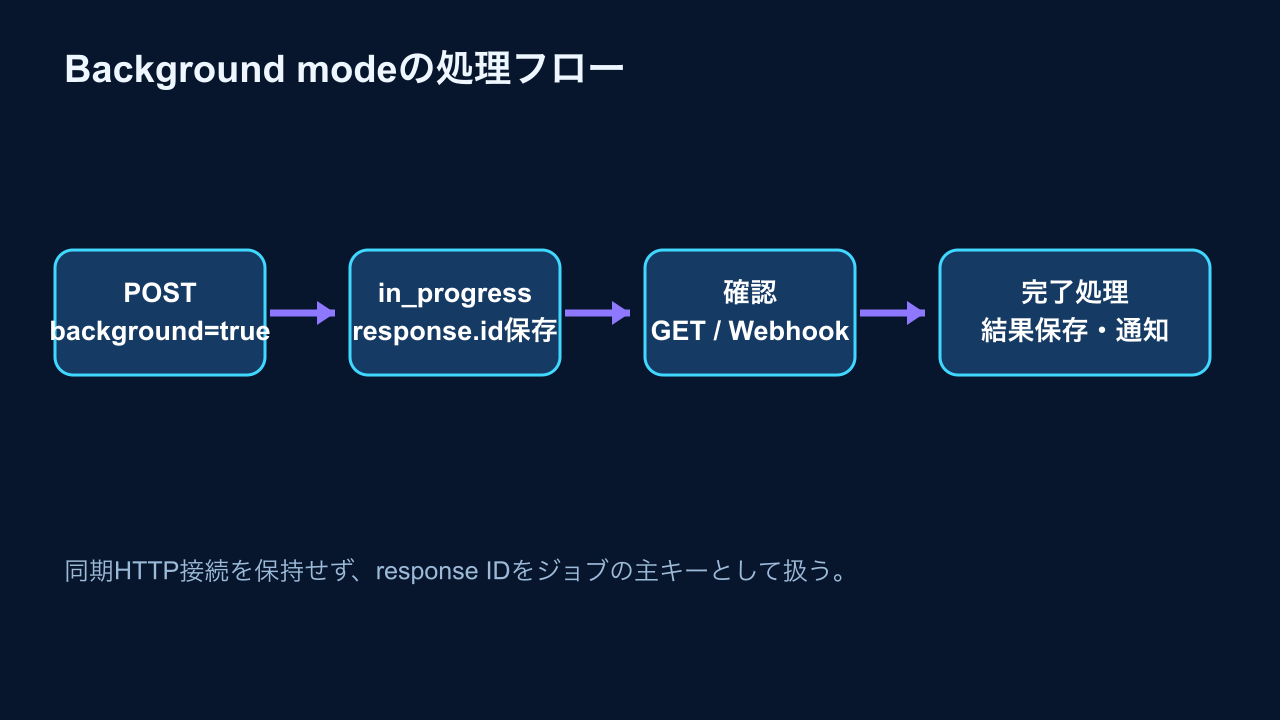
基本フローは4段階です。
- POST /v1/responsesでbackground=trueを指定する
- 返されたresponse.idを保存する
- retrieveまたはWebhookで状態を確認する
- completedならoutput_textを保存し、失敗なら原因を記録する
response IDをメモリだけに置くと、アプリ再起動時に追跡できません。小規模でもSQLiteやジョブテーブルへ保存し、ユーザーの依頼IDとの対応を残してください。
PythonでBackground modeを開始する
公式Python SDKを使う最小例です。モデル名は固定文字列をアプリ設定へ分離し、公式ドキュメントで現在利用できるモデルを確認してください。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-5",
    input="長い調査結果を、論点・根拠・未確認事項に分けて整理してください。",
    background=True,
)

print(response.id)
print(response.status)
重要なのは、createの戻り値からresponse.idを直ちに保存することです。statusがcompletedでなくても異常ではありません。queuedまたはin_progressなら、処理を追跡する段階へ進みます。
APIキーはコードへ直書きせず、環境変数やシークレット管理サービスで扱います。ログにはAPIキー、入力全文、個人情報を残さず、ジョブID、response ID、状態、所要時間など必要最小限を記録します。
ポーリングで完了を待つ
最初の実装ではポーリングが分かりやすいです。ただし、無限ループや毎秒の連続アクセスは避け、間隔、最大回数、全体タイムアウトを設定します。
import time
from openai import OpenAI

client = OpenAI()

def wait_for_response(response_id: str, timeout_seconds: int = 600):
    deadline = time.monotonic() + timeout_seconds
    interval = 2.0

    while time.monotonic() < deadline:
        response = client.responses.retrieve(response_id)

        if response.status == "completed":
            return response

        if response.status in {"failed", "cancelled", "incomplete"}:
            raise RuntimeError(f"background response ended: {response.status}")

        time.sleep(interval)
        interval = min(interval * 1.5, 15.0)

    raise TimeoutError("background response did not finish in time")
指数的に間隔を広げると、短い処理は早く検出し、長い処理ではAPI呼び出しを抑えられます。タイムアウトは処理失敗を意味しません。アプリ側が待機を打ち切っただけなので、同じ入力を新規POSTする前に、保存済みresponse IDを後から再確認します。
Webhookで完了を受け取る
サーバー運用ではWebhookが向いています。OpenAIはbackground responseの完了時にresponse.completedなどのイベントを送信できます。Webhookのpayloadに含まれるresponse IDを使い、Responses APIから本体を取得します。
Webhookの受信処理では次を守ります。
- 公式SDKまたは公式手順で署名を検証する
- リクエストbodyを検証前に改変しない
- event.idを保存して重複処理を防ぐ
- response.idを自分のジョブと照合する
- 短時間で2xxを返し、重い処理は内部キューへ渡す
- 未知のイベント種別を成功扱いで捨てず、観測可能にする
Webhookは再送される可能性があります。メール送信、課金、公開、DB更新などをそのまま繰り返すと問題になります。event.idまたはresponse.idと処理種別を一意キーにして、同じ完了イベントを複数回受けても結果が変わらない冪等設計にします。
ポーリングとWebhookの使い分け
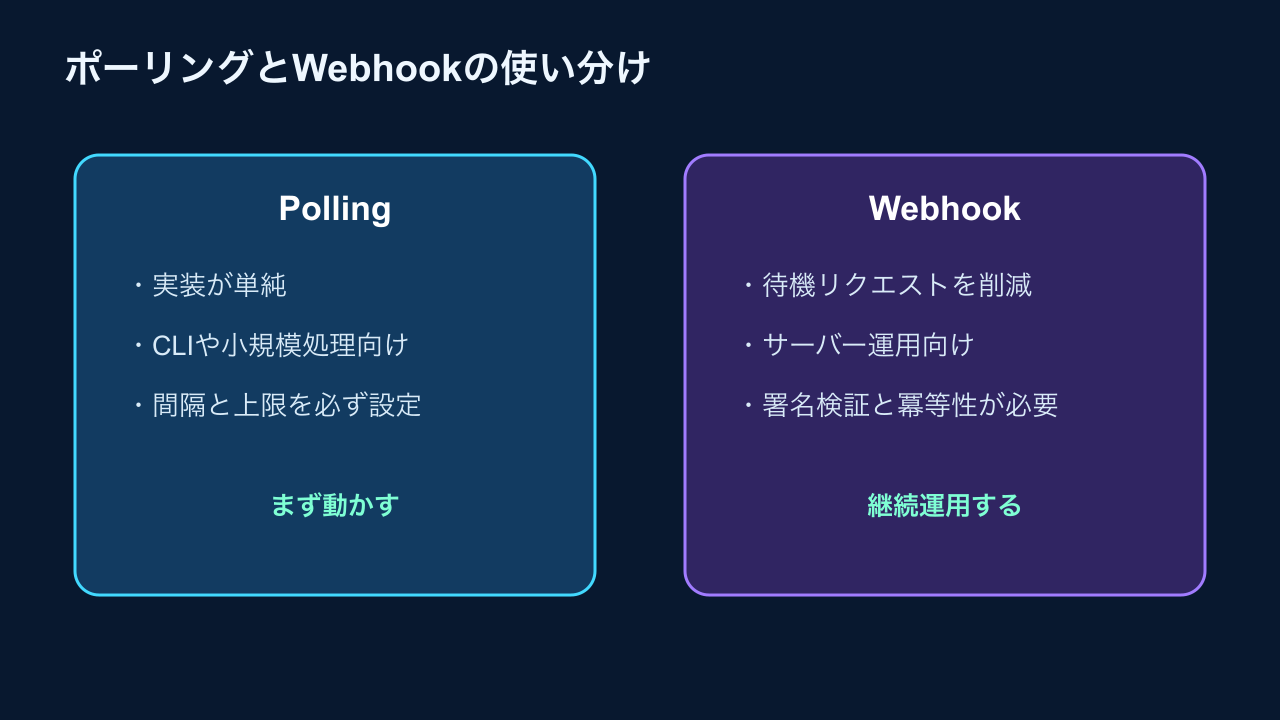
CLI、社内ツール、試作ではポーリングで十分です。公開Webサービスや多数の同時ジョブではWebhookへ移行すると、待機中の呼び出しを減らせます。
実務では両方を組み合わせると堅牢です。通常はWebhookで完了を受け取り、一定時間通知が来ないジョブだけ低頻度ポーリングで回収します。Webhook障害、設定ミス、一時的なネットワーク障害があっても、ジョブが永久に行方不明になりません。
状態をどう保存するか
ジョブテーブルには少なくとも次を持たせます。
- 自分のjob_id
- OpenAIのresponse_id
- queued、in_progress、completedなどの状態
- 作成日時と最終確認日時
- 試行回数
- 入力の参照先または安全なハッシュ
- 結果の保存先
- 最後のエラー種別
- Webhook event_id
入力全文やモデル出力を必ずDBへ複製する必要はありません。個人情報や機密情報を扱う場合は、保存目的、保存期間、アクセス権を決めます。response ID自体も外部サービス上のデータへの参照なので、公開ログへ載せない方が安全です。
POSTタイムアウトと再試行
最も危険なのは、createの送信後にクライアントがタイムアウトし、作成されたか分からない状態で同じPOSTを繰り返すことです。二重ジョブ、二重コスト、二重通知につながります。
アプリ側では、POST前に内部job_idを作り、「送信中」を記録します。レスポンスを受け取ったらresponse_idを保存します。結果が不明な場合はambiguousとして人間確認または照合処理へ回し、自動で無制限再送しません。
GETのretrieveは読み取りなので、ネットワークエラー時に間隔を空けて再試行できます。ただし、404、権限エラー、形式不一致を一時障害と決めつけないでください。
キャンセルを実装する
ユーザーが不要になったジョブや、上限時間を超えたジョブはcancel対象にできます。キャンセルは外部状態を変更するため、誰がどのジョブを止められるか確認します。
キャンセル要求が成功しても、同時に完了している可能性があります。cancelledだけを想定せず、最終状態をretrieveして記録します。UIでは「キャンセル要求済み」と「キャンセル完了」を分けると誤解が減ります。
データ保持とZero Data Retention
Background modeを採用する前にデータ保持要件を確認してください。OpenAIの公式データ管理資料では、Responses APIには保存に関する挙動があり、Background modeはポーリングのためにレスポンスデータを一時保持します。また、Background modeはZero Data Retentionと互換性に制約があります。
医療、法務、社内機密など厳格な保持要件がある場合、「非同期だから便利」で決めず、利用中の契約、データコントロール設定、対象エンドポイントの最新仕様を確認します。要件に合わない場合は、同期処理、別のキュー構成、入力の最小化を検討します。
費用と同時実行数
Background mode自体は処理を無料にする機能ではありません。モデル入力、出力、ツール利用など通常のAPI費用が発生します。非同期化するとユーザーが待たないため、大量投入に気づきにくくなります。
ジョブ投入前に、ユーザー単位の上限、同時実行数、日次予算、最大出力トークン、キャンセル基準を決めます。管理画面ではqueuedとin_progressの件数、失敗率、平均時間、推定費用を確認できるようにします。
よくあるトラブル
statusが長くin_progressのまま
処理内容が重い可能性があります。すぐ再送せず、設定した上限までretrieveします。上限超過後もresponse IDを保持し、後で最終状態を確認します。
Webhookが届かない
エンドポイントの公開URL、TLS、イベント購読、署名検証前のbody処理、応答時間を確認します。Webhookだけに依存せず、回収用ポーリングを用意します。
Webhookが複数回来る
再送を前提に、event.idで重複排除します。処理済みイベントに対しても2xxを返し、同じ副作用を繰り返しません。
output_textが空
status、error、incomplete_details、output配列を確認します。ツール呼び出しや複数出力では、単純なテキスト以外が含まれる場合があります。
アプリ再起動後に追跡できない
response IDを永続化していないことが原因です。create直後に保存し、起動時に未完了ジョブを再読込します。
実運用チェックリスト
- □ background=trueを付ける処理を限定した
- □ create直後にresponse.idを永続化する
- □ ポーリング間隔、上限、全体タイムアウトを設定した
- □ タイムアウトだけで同じPOSTを再送しない
- □ failed、cancelled、incompleteを分けて扱う
- □ Webhook署名を公式手順で検証する
- □ event.idで重複処理を防ぐ
- □ response.idを自分のjob_idと照合する
- □ データ保持とZDR要件を確認した
- □ 同時実行数と費用上限を設定した
- □ キャンセル権限と最終状態確認を実装した
- □ ログからAPIキーと機密入力を除外した
関連する設計
Responses APIで関数を安全に呼ぶ設計は、Function Calling入門とStructured OutputsとFunction Callingの違いで解説しています。AIエージェント全体の構成を整理したい場合は、Pythonで動かすAIエージェントの最小構成も参考になります。
Background modeは、エージェントの能力を増やす機能ではありません。処理の実行と受け取りを切り離し、長時間ジョブを運用可能にする基盤です。
まとめ
OpenAI Responses APIのBackground modeは、長い処理をHTTP接続から切り離し、response IDで追跡する非同期実行機能です。小規模では上限付きポーリング、継続運用では署名検証と冪等性を備えたWebhookを使います。
成功の鍵は、response IDの永続化、曖昧なPOSTの無制限再送防止、状態別処理、データ保持確認です。まず1種類の長時間処理だけで導入し、所要時間、失敗、費用、Webhook再送を観測してから対象を広げてください。
コメント